KI-Suchoptimierung im E-Commerce: Das Playbook 2026 für GEO, AEO und Agentic Commerce

Von Robin Laseur

Die Impressionen steigen, die Klicks bleiben flach, und spätestens beim zweiten Quartalsreview hat jemand das Ganze zum CTR-Problem erklärt. Das Problem liegt in den Leitungen, und Leitungen verlegt man in einer festen Reihenfolge. KI-Suchoptimierung im E-Commerce heißt, einen Shop für die KI-Systeme lesbar, nutzbar und zitierbar zu machen, die Kauffragen beantworten, bevor jemand überhaupt eine Ergebnisseite sieht. Sie umfasst drei Ebenen: Zugang, Produktdaten und Reputation. Die meisten veröffentlichten Pläne behandeln diese Ebenen als parallele Arbeitsstränge. Sie bauen aber aufeinander auf, und genau in dieser Reihenfolge liegt das Geld.
Im Folgenden steht der Arbeitsplan: welche Ebene Sie zuerst prüfen, was jeder Fall tatsächlich verlangt, wer verantwortlich ist, und an welchem Punkt Agentic Commerce keine Content-Frage mehr ist, sondern eine Frage der Berechtigung.
Was KI-Suchoptimierung im E-Commerce 2026 umfasst
Die Disziplin besteht aus drei Ebenen. Zugang: Können KI-Crawler und Agents Ihre Seiten und Ihren Katalog überhaupt erreichen? Produktdaten: Sind die Daten, die sie finden, vollständig genug, um sie mit den Anforderungen eines Käufers abzugleichen? Reputation: Beschreiben andere Quellen im Netz Ihre Marke so, wie Sie sie selbst beschreiben würden? Jede Ebene hat andere Verantwortliche und andere Werkzeuge.
Die Abkürzungen sind nicht festgelegt und weitgehend austauschbar. GEO (Generative Engine Optimization) bedeutet, Inhalte so zu gestalten, dass sie in generierten Antworten verwendet werden. AEO (Answer Engine Optimization) bedeutet, Inhalte so zu gestalten, dass sie selbst die Antwort sind. AIO meint meist Googles AI Overviews, und das ist eine Oberfläche unter mehreren, nicht das ganze Feld. Legen Sie sich intern auf einen Begriff fest und bleiben Sie dabei. Die Begriffsdebatte kostet Meetings, die am Katalog besser investiert wären.
Für eine mittelgroße Marke zählen weniger Oberflächen, als der Streit um Abkürzungen vermuten lässt: Google AI Overviews und AI Mode, ChatGPT, Microsoft Copilot, Perplexity und Gemini. Amazons Rufus liest einen Katalog, den Sie anderswo pflegen, und fällt deshalb aus diesem Plan heraus. Einige dieser Oberflächen lesen einen strukturierten Produktfeed. Alle lesen Ihre Seiten. Diese Aufteilung entscheidet, welches Team die Arbeit macht, und genau deshalb benennt man in der Praxis die Ebenen statt der Abkürzungen.
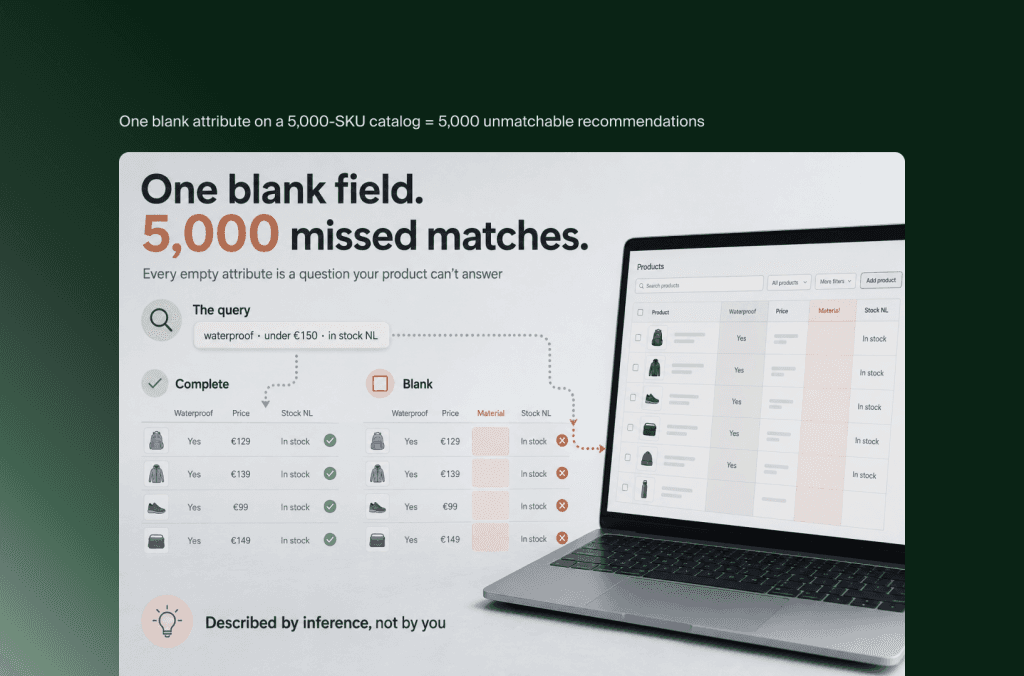
Den Punkt zur Reihenfolge übergehen die meisten Ratgeber. Eine Marke mit hervorragenden Bewertungen und einer Firewall, die KI-Crawlern einen 403 zurückgibt, ist unsichtbar, und daran ändert keine Publisher-Outreach etwas. Eine Marke mit sauberem Zugang und leeren Produktattributen wird gecrawlt und danach übergangen. Ein System, das nach „wasserdicht, unter 150 €, in den Niederlanden auf Lager“ sucht, kann nichts mit leeren Feldern abgleichen. Reputationsarbeit zahlt sich erst aus, wenn die beiden Ebenen darunter stehen. Unser früherer Beitrag zu GEO für Commerce geht ausführlicher auf die Begriffe ein. Hier geht es um die Reihenfolge.
Der Einstieg: Welche Ebene Sie Sichtbarkeit kostet
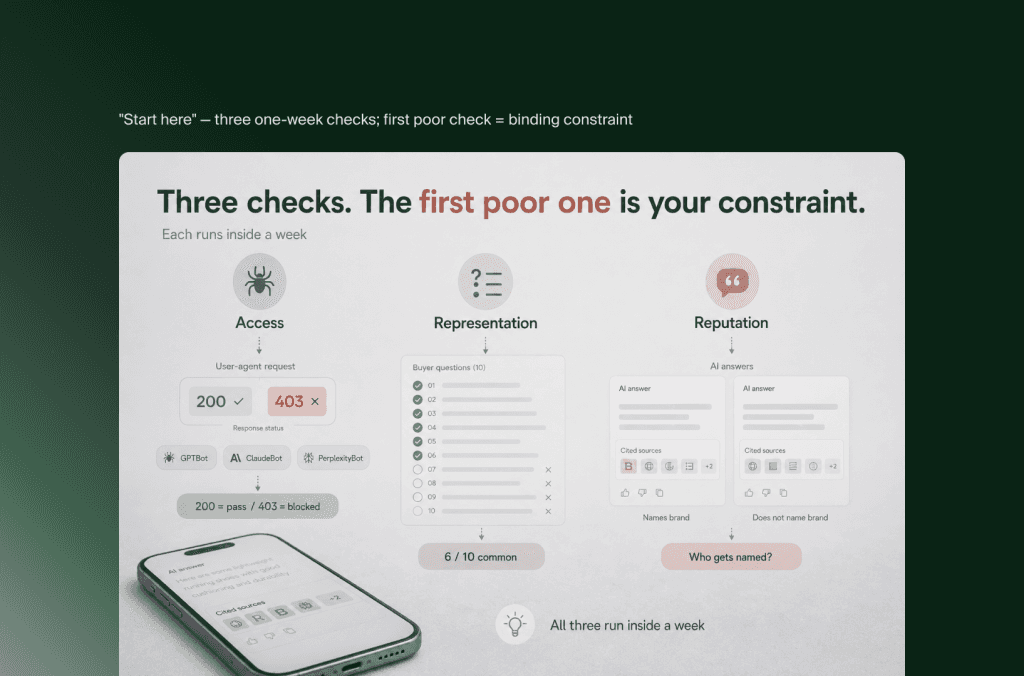
Drei Checks trennen die Ebenen, und alle drei passen in eine Woche. Rufen Sie eine Seite mit dem User Agent eines KI-Crawlers ab und prüfen Sie den Statuscode. Lesen Sie eine Produktseite mit den Fragen im Kopf, die ein Käufer vor dem Kauf stellt. Testen Sie zehn Prompts aus Ihrer Kategorie auf zwei KI-Plattformen und notieren Sie, wer genannt wird. Der erste Check, der schlecht ausfällt, ist Ihr Engpass.
Der Zugangscheck. Rufen Sie eine Produktseite und eine Kollektionsseite als GPTBot, OAI-SearchBot, ClaudeBot und PerplexityBot ab. Ein 200 mit vollständigem HTML heißt bestanden. Ein 403, ein 429 oder eine fast leere Antwort ist Ihr Befund, und der stammt meist vom CDN oder der Firewall, nicht aus der robots.txt. Notieren Sie Datum und Statuscodes, denn das ist die Ausgangsbasis, mit der Sie später vergleichen.
Der Produktdatencheck. Nehmen Sie die Produktseite mit dem höchsten Umsatz und schreiben Sie die zehn Fragen auf, die ein Käufer vor dem Checkout stellt: Größe, Passform, Material, Pflege, Kompatibilität, Lieferzeit, Rückgabebedingungen und drei Fragen, die nur Ihre Kategorie betreffen. Zählen Sie, wie viele davon auf der Seite in einfachem, auslesbarem Text beantwortet werden. Sechs von zehn ist üblich. Alles darunter erklärt viele der Empfehlungen, die Ihnen entgehen.
Der Reputationscheck. Testen Sie zehn Prompts mit Kaufabsicht aus Ihrer Kategorie auf zwei KI-Plattformen. Notieren Sie pro Prompt drei Dinge: ob Ihre Marke genannt wird, ob eine Ihrer Seiten zitiert wird und auf welche Quellen sich die Antwort stattdessen stützt. Die Spalte mit den zitierten Quellen ist die nützlichere Hälfte der Stichprobe, denn sie zeigt die Oberflächen, auf denen Sie im Wettbewerb stehen.
Teams fangen meist bei Ebene drei an. Das ist die sichtbarste Arbeit, sie liefert die vorzeigbarsten Folien und lässt sich der Geschäftsführung am leichtesten erklären. Sie ist aber auch die langsamste und teuerste der drei. In den KI-Beratungsprojekten von Flatline beginnt die Reihenfolge, die sich in echten Teams bewährt, bei dem Check mit dem klarsten Problem. Nicht bei der Ebene mit den meisten Konferenzvorträgen.
Fall A: Wenn KI-Systeme Ihren Shop nicht erreichen
Die Zugangsebene besteht aus Ihrer robots.txt, Ihren CDN-Regeln, Ihrer Web Application Firewall und bei Shopify der Bot-Authentifizierung, die festlegt, welche automatisierten Anfragen als legitim gelten. Regel und Verhalten klaffen hier öfter auseinander, als Teams erwarten. Eine robots.txt, die GPTBot zulässt, bringt wenig, wenn die Sicherheitsebene davor dieselbe Anfrage mit 403 beantwortet.
Das Symptom zeigt sich früh in der technischen Arbeit. Große Crawls von Shopify-Shops bleiben an 429-Antworten hängen. Im Bericht sieht das nach einem Content-Problem aus, tatsächlich liegt es an der Sicherheitsebene. Seit August 2025 unterstützt Shopify signierte Crawler-Anfragen über Web Bot Auth, und eine gültige Signatur macht den Unterschied zwischen einem vollständigen und einem lückenhaften Audit. Unsere Anleitung zu Screaming Frog auf Shopify beschreibt diese Konfiguration im Detail.
Zu llms.txt gehört eine ehrliche Einschätzung. Eine solche Datei zu veröffentlichen kostet einen Nachmittag, und keine große Suchmaschine hat öffentlich zugesagt, sie als Anweisung für den Abruf von Inhalten zu beachten. Sehen Sie sie als günstige Wette mit unbewiesenem Ertrag, nicht als Lösung für irgendetwas auf dieser Liste.
Die größere Entscheidung in diesem Fall ist eine Grundsatzfrage im technischen Gewand. Wer KI-Crawler blockiert, hält seine Inhalte aus Trainingsdaten heraus und verschwindet gleichzeitig aus generierten Antworten. Diese beiden Ziele ziehen in entgegengesetzte Richtungen, und kein Entwickler sollte das um 16 Uhr in einer Firewall-Regel entscheiden müssen. Jemand mit Verantwortung für die Marke muss schriftlich festhalten, welche Crawler willkommen sind und warum. Eine Seite reicht. Erst die schriftliche Fassung verhindert, dass die Regel bei jeder geänderten CDN-Standardeinstellung verrutscht.
Fall B: Wenn Systeme Ihren Shop lesen, aber Ihre Daten nicht nutzen können
Bei den Produktdaten geht es um Vollständigkeit. KI-Systeme gleichen Produkte mit Anforderungen ab, also ist jedes leere Attribut eine Frage, die Ihr Produkt nicht beantworten kann: GTIN, Marke, Material, Größe, Gewicht, Verfügbarkeit, Kompatibilität. Dünne Beschreibungen und lückenhafte strukturierte Daten führen auf unterschiedlichen Wegen zum selben Ergebnis: ein Produkt, das nie auf die Shortlist kommt.
Drei Dinge tragen das meiste Gewicht. Strukturierte Daten in allen Templates (mindestens Product- und Review-Markup, FAQPage dort, wo es echte Fragen gibt) liefern Systemen Fakten in fertig ausgelesener Form, die sie sonst aus dem Layout ableiten müssten. Vollständige Attribute im Katalog entscheiden, ob eine Suchanfrage voller Anforderungen Sie überhaupt findet. Antworten auf Fragen vor dem Kauf, im Seitentext selbst und nicht in einem Bild oder einem Tab, der erst per Klick lädt, entscheiden, ob der Treffer die Nachfrage des Käufers übersteht.
Es gibt einen Folgeeffekt, den Sie kennen sollten, bevor jemand über Textlängen streitet. Shopify Catalog leitet zusätzliche Produktattribute aus Transaktionssignalen auf der gesamten Plattform ab. Ein unvollständiger Katalog wird KI-Kanälen also trotzdem beschrieben, nur eben per Ableitung und nicht von Ihnen. Bei einem Katalog mit 5.000 SKUs ist ein leeres Attribut keine kleine Lücke. Es sind 5.000 Empfehlungen, bei denen die Anforderung eines Käufers nicht mit Ihrem Produkt abgeglichen werden kann, und im Spiel ist dann die abgeleitete Version Ihres Produkts.
In welcher Reihenfolge Sie Feld für Feld über Templates und Varianten umsetzen, ist ein eigenes Projekt und gehört in ein Ticket, nicht in ein Strategiepapier. Auf Planebene ist die Entscheidung enger: welche SKUs Sie zuerst vervollständigen. Nach Umsatz, nicht nach Alphabet.
Fall C: Wenn die Antwort alle zitiert außer Ihnen
Reputation ist die Ebene, auf der Quellen außerhalb Ihrer Kontrolle Ihre Produkte beschreiben. Generierte Antworten setzen sich zusammen aus Bewertungen, Vergleichen von Publishern, Diskussionen in Ihrer Kategorie und strukturierten Markendaten, die über Profile und Verzeichnisse verstreut sind. Über keine Ebene wird mehr geschrieben, und zu keiner gibt es weniger Rat zur Reihenfolge. Deshalb bleibt dieser Teil kurz und die Zuordnung konkret.
Fünf Oberflächen liefern den Großteil der Zitate für E-Commerce-Marken:
Bewertungen auf Ihren eigenen Produktseiten, denn sie liefern die Praxisdetails, auf die generierte Antworten zurückgreifen, wenn eine Anfrage eine Anforderung wie „für breite Füße“ oder „für eine Hochzeit am Strand“ enthält.
Bewertungsplattformen von Dritten, auf denen Menge und Aktualität mehr zählen als die Note.
Übersichtsartikel und Vergleiche von Publishern, die überproportional oft zitiert werden, weil sie schon als Empfehlung aufgebaut sind.
Diskussionen zu Ihrer Kategorie auf Reddit, YouTube und in Fachforen, denn dort äußern sich Menschen, ohne dass eine Marke mitredet.
Einheitliche Markendaten in Profilen und Verzeichnissen, damit Markenname, Kategorie, Land und Produktlinien überall gleich lauten, wo ein System sie prüft.
Namentliche Autorschaft und belegte Expertise gehören ebenfalls zu dieser Ebene. Eine Seite mit einem echten Autor, einer echten Qualifikation und einem Datum behandelt ein System leichter als Quelle als denselben Text ohne Namen. Erfassen Sie zuerst, welche Quellen bei Ihren zehn Prompts derzeit zitiert werden. Outreach ohne diese Übersicht ist Raten mit Budget.
Wo Agentic Commerce den Plan ändert und wo die Berechtigung ihn stoppt
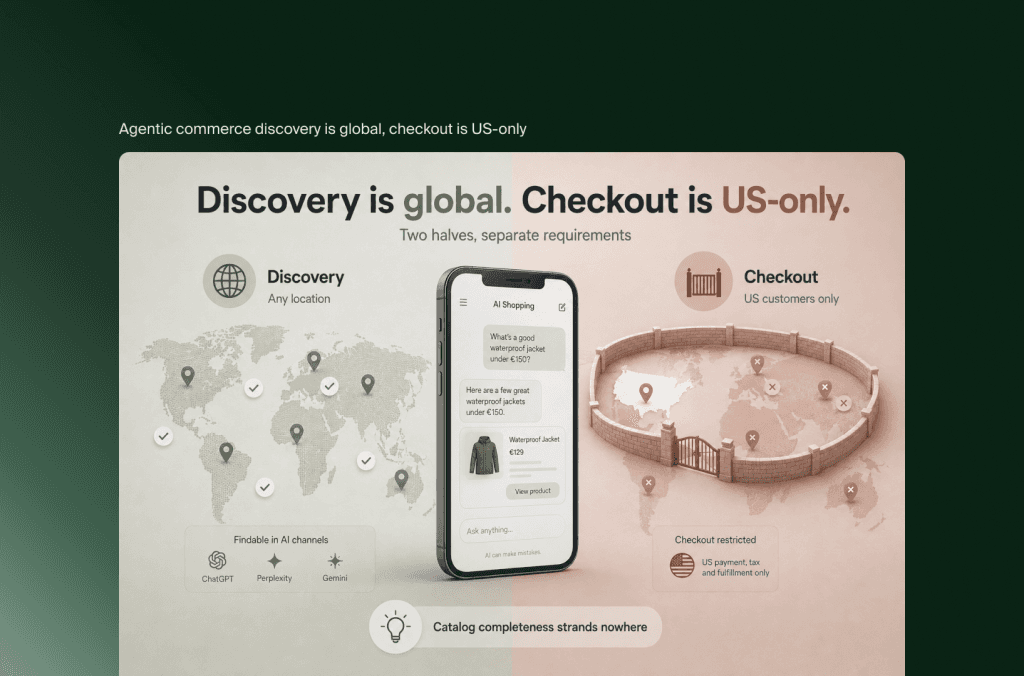
Agentic Commerce besteht aus zwei Hälften, die oft in einen Topf geworfen werden. Auffindbarkeit und Checkout haben unterschiedliche Voraussetzungen. Produkte können in KI-Kanälen gefunden werden, ohne dass der Shop etwas tun muss, während der integrierte Agentic Checkout nur Kunden in den Vereinigten Staaten angezeigt wird. So steht es in Shopifys eigener Dokumentation zu den Voraussetzungen. Für eine europäische Marke stellt diese eine Zeile den Plan um: Die Arbeit am Katalog zahlt sich über Auffindbarkeit schon heute voll aus, die Arbeit am Checkout wartet auf die Berechtigung.
Der Ablauf ist eher administrativ als technisch. Agentic Storefronts laufen auf Shopify Catalog, berechtigte Shops sehen ihre teilnehmenden Kanäle im Shopify-Admin, und für den Zugang müssen Sie die ergänzenden Bedingungen für Agentic Storefronts akzeptieren. Ob ein Shop berechtigt ist, entscheidet Shopify nach eigenem Ermessen. Die Kanäle verhalten sich unterschiedlich, und das hat Folgen für den Betrieb. Käufe über ChatGPT werden im Checkout Ihres eigenen Shops abgeschlossen, deshalb gelten dort die Einschränkungen für eingebettete Checkouts nicht. Unser Beitrag zur Shopify Agentic Storefront erklärt die Einrichtung für Teams, die so weit sind.
Die Folge für die Messung übersehen die meisten Pläne. Bestimmte Shopify-Funktionen, darunter Custom Pixels, werden auf einigen Agentic-Kanälen nicht unterstützt. Bestellungen können also mit Kanalzuordnung in Shopify eingehen, während das clientseitige Tracking nichts zeigt. Der erste ehrliche Bericht über Agentic Commerce kommt deshalb aus der Ansicht Bestellungen, nicht aus Ihrem Analytics-Dashboard. Teams, die das erst nach einem Quartal Reporting merken, schließen oft, dass der Kanal nichts gebracht hat.
Die eigentliche Grenze für den Agentic-Plan einer europäischen Marke ist also die Geografie, nicht die technische Reife. Das ist bequemer, als es klingt, denn alles aus Fall B ist Vorarbeit für beide Hälften. Ein vollständiger Katalog bringt jetzt Auffindbarkeit und erfüllt später die Voraussetzungen für den Checkout. Damit ist er die einzige Investition in diesem Artikel, die keine Änderung der Berechtigung entwerten kann.
Unsicher, wo Sie anfangen sollen? Die Standardfolge für 90 Tage
Wenn alle drei Checks mittelmäßig ausfallen, gehen Sie so vor: Zugang in Woche eins und zwei, Produktdaten für Ihre fünfzig umsatzstärksten SKUs in Woche drei bis acht, Reputation ab Woche sechs. Halten Sie eine datierte Ausgangsbasis fest, bevor sich irgendetwas ändert. Das ist die sichere Standardwahl, weil eine Zugangssperre jede spätere Messung unlesbar macht.
Bei der Messung hilft nur Klartext über den aktuellen Stand. Heute lässt sich eine Ausgangsbasis festhalten für: Prompt-Stichproben mit einem festen Fragenset, KI-Referral-Traffic als eigenes Segment in Analytics und die Kanalzuordnung in den Shopify-Bestellungen. Noch nicht zuverlässig nachverfolgen lässt sich der Weg von einer Markennennung in einer generierten Antwort zu einer bestimmten Bestellung, denn eine Nennung ohne Klick hinterlässt keine Session und kein Pixel-Event. Berichten Sie die erste Gruppe monatlich und bezeichnen Sie die zweite als Richtungswert. Wer sie als Ursache präsentiert, verliert das Budget am schnellsten, sobald jemand die Behauptung prüft.
Über alle Projekte hinweg zeigt sich dasselbe Muster: Diese Pläne scheitern an Übergaben, nicht an Taktiken. Der Zugang liegt bei einem Entwickler, die Attribute beim Merchandising, die Antworten beim Content-Team und die Outreach beim Marketing. Vier Verantwortliche, eine Reihenfolge und niemand, der alle vier Spalten sieht. Die Spalte mit den Verantwortlichen in der Tabelle oben leistet mehr, als man ihr ansieht.
Häufig gestellte Fragen
Ist klassisches SEO für die KI-Suche noch wichtig?
Ja, und es bleibt das Fundament. Crawlbarkeit, Canonical-Struktur, Ladezeit und interne Verlinkung entscheiden, ob KI-Systeme Ihre Seiten überhaupt abrufen können. Die klassische Suche bringt außerdem nach wie vor den Großteil des E-Commerce-Traffics. Betrachten Sie KI-Suchoptimierung als zusätzliche Ebene auf einer funktionierenden technischen Basis, nicht als Ersatz dafür.
Brauchen wir eine llms.txt-Datei?
Die Veröffentlichung kostet sehr wenig, und keine große KI-Suchmaschine hat öffentlich zugesagt, sie als Anweisung für den Abruf von Inhalten zu beachten. Legen Sie eine an, wenn es einen Nachmittag dauert, und erwarten Sie keinen messbaren Effekt. Sie ersetzt weder den Zugang für Crawler noch vollständige Produktdaten, und genau diese beiden Dinge verändern nachweislich die Ergebnisse.
Wie lange dauert es, bis diese Arbeit Ergebnisse zeigt?
Behobene Zugangsprobleme zeigen sich innerhalb weniger Tage, weil Crawler schnell zurückkommen, sobald sich die Antworten ändern. Arbeit an Katalog und Inhalten schlägt sich meist innerhalb von vier bis acht Wochen nieder, während die Seiten neu abgerufen werden. Reputationsarbeit bewegt sich im Quartalsrhythmus. Halten Sie zuerst eine datierte Ausgangsbasis fest, sonst lässt sich die Verbesserung nicht von den normalen Schwankungen generierter Antworten unterscheiden.
Kann ein Shop außerhalb der USA über Agentic Commerce verkaufen?
Produkte berechtigter Shops sind unabhängig vom Standort in KI-Kanälen auffindbar, aber der integrierte Agentic Checkout von Shopify wird nur Kunden in den Vereinigten Staaten angezeigt. Eine europäische Marke sollte deshalb jetzt Katalog und Attribute vervollständigen, was sich über Auffindbarkeit sofort auszahlt. Die Aktivierung des Checkouts ist ein späterer Schritt, der davon abhängt, wann die Berechtigung ausgeweitet wird.
Das Wichtigste in Kürze
Die drei Ebenen bauen aufeinander auf. Erst Zugang, dann Produktdaten, dann Reputation. Budget für Reputation zahlt sich nur aus, wenn die beiden Ebenen darunter bereits stehen.
Erst die Diagnose, dann die Therapie. Eine Crawler-Anfrage, eine Produktseite im Abgleich mit echten Käuferfragen und zehn Prompts auf zwei Plattformen zeigen Ihnen, in welchem Fall Sie stecken.
Die Regel für den Zugang von KI-Crawlern gehört schriftlich festgehalten und in die Hand von jemandem, der über die Marke entscheidet. Denn Blockieren schützt Inhalte und nimmt Sie im selben Zug aus den Antworten.
Ein vollständiger Katalog ist die einzige Investition, die keine Änderung der Berechtigung entwerten kann. Er bringt Marken überall schon jetzt Auffindbarkeit und erfüllt die Voraussetzungen für den Agentic Checkout, wo immer dieser verfügbar wird.
Die Reihenfolge in diesem Playbook ist keine Vorliebe. Sie ergibt sich daraus, wie die Ebenen aufeinander wirken. Ein Team, das diese Woche die drei Checks macht, zu jedem Schritt die verantwortliche Person notiert und seine Ausgangsbasis datiert, weiß im nächsten Quartal, welcher dieser Fälle die Sichtbarkeit tatsächlich gebremst hat. Und das ist ein anderes Gespräch als eines, das mit einer flachen CTR-Kurve beginnt.
Verwandte Artikel


