llms.txt, Web Bot Auth und Crawler-Richtlinie: die Zugriffsebene der KI-Suche

Von Robin Laseur
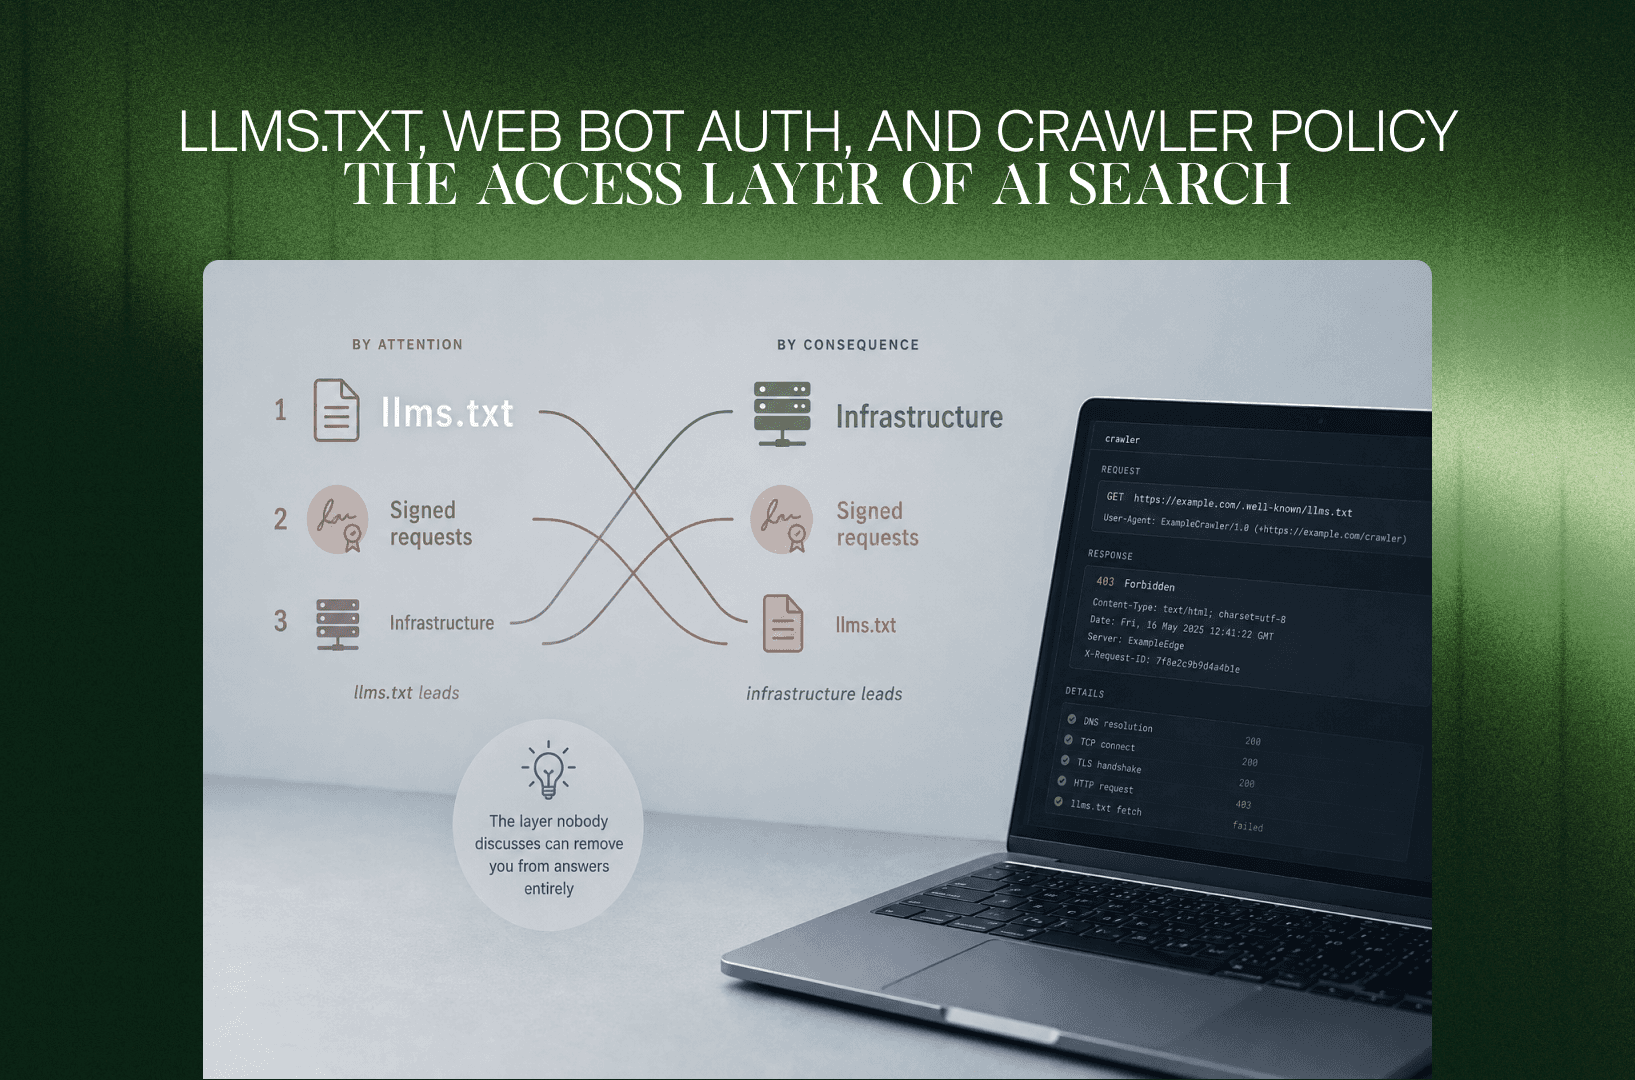
Die Zugriffsebene ist der Teil der KI-Suche, über den am Ende die Person entscheidet, die zuletzt an der Firewall gearbeitet hat. Für die meisten E-Commerce-Teams besteht sie aus drei Dingen, die sich sehr unterschiedlich verhalten: einer Datei, über die alle reden und die kaum ein System liest, einem Satz Infrastrukturregeln, der still darüber bestimmt, ob KI-Crawler Ihren Katalog überhaupt erreichen, und einem Verfahren mit signierten Anfragen, das festlegt, welche automatisierten Besucher als legitim gelten. Nach Aufmerksamkeit sortiert steht llms.txt ganz oben. Nach Folgen für einen Produktkatalog sortiert steht es ganz unten.
Diese Umkehrung ist einen Nachmittag Ihrer Zeit wert. Denn genau die Ebene, über die niemand spricht, kann einen Shop vollständig aus generierten Antworten entfernen.
Die Erwartung: llms.txt als robots.txt des KI-Zeitalters
Die Argumentation wirkt auf den ersten Blick stimmig. Suchmaschinen lesen robots.txt, also sollten KI-Systeme eine vergleichbare Datei lesen. Ein kuratierter Markdown-Index Ihrer wichtigsten Seiten klingt genau nach dem, was ein Modell braucht: weniger Rauschen, keine Tokens für Navigation und Cookie-Banner, eine klare Aussage darüber, was die Website ist und wo die Substanz liegt.
Der Vorschlag selbst ist durchdacht. Er stammt von Jeremy Howard von Answer.AI aus dem September 2024 und war als Hilfe für Sprachmodelle gedacht, eine Website beim Erstellen einer Antwort zu nutzen. Ernsthafte Unternehmen veröffentlichen eine. Eine Datei online zu stellen dauert weniger als eine Stunde. Zusammen ergibt das eine vernünftige Schlussfolgerung, und deshalb steht der Punkt bei so vielen E-Commerce-Teams auf der Roadmap.
Was die Untersuchungen zeigen
Die Position von Google ist dokumentiert und muss nicht hergeleitet werden. In der Anleitung zu KI-Funktionen und Ihrer Website steht, dass keine neuen maschinenlesbaren Dateien, KI-Textdateien oder besonderen schema.org-Daten nötig sind, um in diesen Funktionen zu erscheinen. Der Leitfaden zur Optimierung für generative KI-Suche wurde im Juni 2026 mit derselben Aussage zu Spezialdateien aktualisiert. Mitglieder des Google-Search-Teams sagen das seit 2025 auch offen.
Die unabhängigen Daten weisen in dieselbe Richtung. SE Ranking untersuchte 300.000 Domains, eine Studie, die dieses Jahr breit aufgegriffen wurde, und kam auf eine Verbreitung von rund zehn Prozent. Das Team baute ein Modell, um zu prüfen, ob eine vorhandene llms.txt mit der Häufigkeit von Zitaten zusammenhängt; als die Datei aus dem Modell entfernt wurde, sagte es besser vorher. Die Variable verhielt sich also wie Rauschen und nicht wie ein Signal. Eine weitere Auswertung, berichtet von Originality.ai, zeigte: Die Verbreitung wuchs stark, während die große Mehrheit der veröffentlichten Dateien nie von einem KI-System abgerufen wurde.
Es gibt eine echte Unstimmigkeit, und sie sitzt bei Google selbst. Lighthouse in Chrome bekam im Mai 2026 einen Audit für agentisches Browsing, der auf llms.txt prüft, genau zu der Zeit, in der Search Central Website-Betreibern sagte, die Datei sei nicht nötig. Beide Teams sind in ihrem eigenen Rahmen konsistent, denn sie beschreiben unterschiedliche Abnehmer: auf der einen Seite einen Suchindex, auf der anderen agentische Browser und Coding-Assistenten.
Und das ist die Zusammenfassung, die trägt. Die Systeme, die llms.txt heute nachweislich lesen, richten sich an Entwickler: Coding-Assistenten, die Dokumentation abrufen, Agent-Frameworks und einige Crawler, die Verbreitung messen. Behauptungen, bestimmte KI-Suchprodukte für Verbraucher würden die Datei abrufen, widersprechen sich zwischen den Quellen und wurden von den Anbietern nie bestätigt. Wer Produkte verkauft, hat einen anderen Anwendungsfall.
Warum die Lücke besteht
Drei Mechanismen erklären, warum eine so vernünftige Idee so wenig bringt.
Eine selbst erklärte Datei hat keine Prüfung hinter sich. Ein Dokument, in dem eine Website selbst angibt, worum es geht, ohne dass jemand die Angabe prüft, hat einen offensichtlichen Vorläufer: das Keywords-Meta-Tag. Jedes System, das darauf baut, übernimmt eine manipulierbare Eingabe. Retrieval-Systeme haben längst eine stärkere Quelle: die Seiten selbst, gecrawlt und bewertet.
Das Problem, das sie löst, ist ein Dokumentationsproblem. Sparsamer Umgang mit Tokens zählt enorm, wenn ein Agent API-Referenzen liest, um Code zu schreiben. Die Frage eines Käufers wird über Produktdaten, Bewertungen und Kategorieinhalte beantwortet, die die Retrieval-Pipeline längst verarbeitet. Der Schmerz, den llms.txt nimmt, ist echt, und ihn spüren Anbieter von Developer-Tools, nicht Shops mit einem Katalog.
Niemand setzt sie durch. Hinter dem Format steht kein Standardisierungsgremium, und kein Anbieter ist verpflichtet, sich daran zu halten. Deshalb gehen die Zahlen zur Verbreitung auseinander, und deshalb muss man das Verhalten jedes Anbieters messen statt annehmen.
Nichts davon macht eine Veröffentlichung falsch. Es macht sie zu einer günstigen Übung mit geringer Erwartung, die nirgends an die Spitze einer Commerce-Roadmap gehört.
Was die Zugriffsebene wirklich steuert
Hier ist die Ebene, die über das Ergebnis entscheidet, mit dem, was jeder Mechanismus konkret regelt.
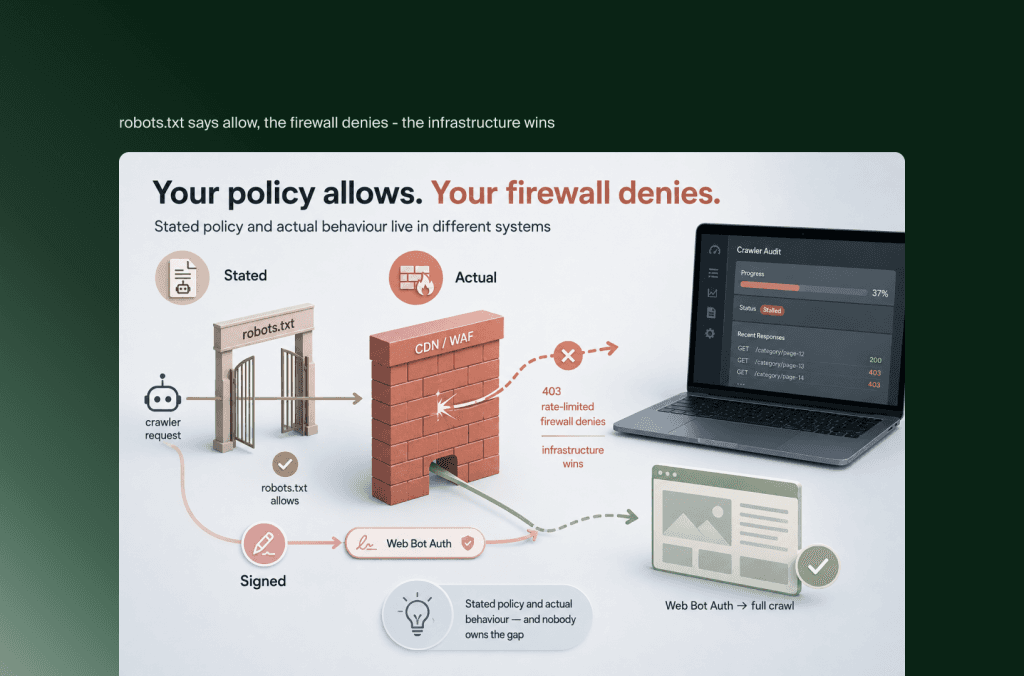
Die Zeile mit Folgen ist die zweite. Richtlinie und Verhalten laufen ständig auseinander: Eine robots.txt, die einen KI-Crawler zulässt, bedeutet nichts, wenn die Sicherheitsebene davor dieselbe Anfrage abweist. Teams merken das beim Audit der eigenen Website, wenn ein großer Crawl eines Shopify-Shops an Rate-Limit-Antworten hängen bleibt, die im Report wie ein Content-Problem aussehen und in Wahrheit aus der Sicherheitsebene kommen. Seit Shopify signierte Crawler-Anfragen über Web Bot Auth unterstützt, entscheidet diese Signatur über ein vollständiges oder ein halbes Audit. Unsere Anleitung zu Screaming Frog auf Shopify zeigt die Konfiguration in der Praxis.
Das Muster, das man sich merken sollte: Ihre erklärte Richtlinie liegt in einem System, Ihr tatsächliches Verhalten in einem anderen, und niemand ist dafür zuständig, beide in Übereinstimmung zu halten.
Die Entscheidung, die niemand aufschreibt
Unter der technischen Arbeit liegt eine Richtlinienfrage, die meist nebenbei beantwortet statt entschieden wird: Welche automatisierten Besucher sind willkommen, und warum.
Die Frage ist schwerer, als sie aussieht, denn zwei verschiedene Tätigkeiten laufen unter einem Namen. Crawlen für Trainingsdaten und Crawlen, um gerade jetzt eine Antwort für jemanden zusammenzustellen, der nach Ihrer Kategorie fragt, sind zwei Dinge mit zwei Arten von Folgen. Und sie lassen sich nicht immer am User Agent unterscheiden. Wer das Erste einschränkt, schränkt manchmal auch das Zweite ein. Für einen Produktkatalog fällt dieser Tausch unangenehm aus: Geschützt werden Produktinformationen, die Sie gerade deshalb veröffentlichen, damit Menschen sie finden.
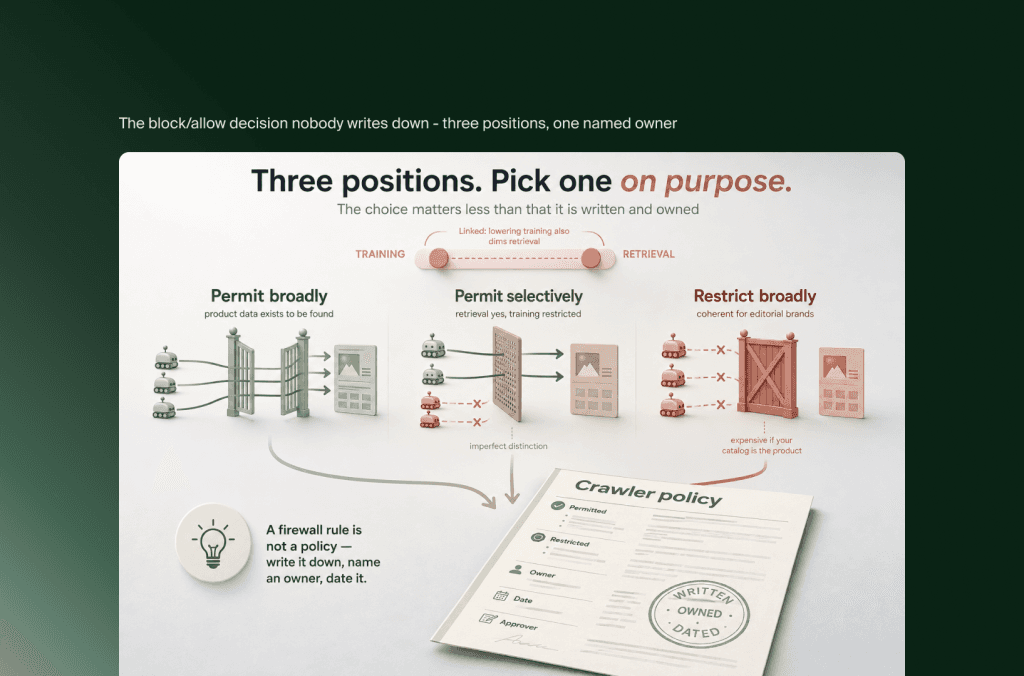
Drei Positionen sind vertretbar, und ein Shop sollte eine davon bewusst einnehmen.
Breit zulassen, mit der Begründung, dass Produktdaten da sind, um gefunden zu werden, und dass Präsenz in generierten Antworten mehr wert ist als Kontrolle darüber, wie ein Modell Ihren Katalog kennengelernt hat. Selektiv zulassen, also Crawler durchlassen, die Antworten abrufen, und jene einschränken, die vor allem Trainingsdaten sammeln, im Wissen, dass die Trennung unsauber ist und bei jeder Änderung der Crawler-Dokumentation neu geprüft werden muss. Oder breit einschränken, was für Marken schlüssig ist, deren redaktionelle Inhalte das Produkt sind, und teuer für einen Shop, bei dem der Katalog das Produkt ist.
Wichtiger als die Wahl ist, dass sie als schriftliche Entscheidung mit einer verantwortlichen Person existiert. Eine Firewall-Regel, die während eines Vorfalls hinzugefügt wurde, ist keine Richtlinie. Und sie überlebt jede Erinnerung daran, warum sie einmal entstand.
Was Sie diese Woche prüfen können
Fünf Prüfungen, keine davon braucht Budget.
Rufen Sie Ihre eigenen Seiten als KI-Crawler ab. Fordern Sie eine Produktseite und eine Kategorieseite an und senden Sie dabei die User Agents der großen KI-Crawler mit. Notieren Sie den Statuscode und ob die Antwort Ihr vollständiges HTML enthält. Eine Abweisung oder ein leerer Body ist Ihre Antwort.
Vergleichen Sie erklärte Richtlinie und beobachtetes Verhalten. Lesen Sie Ihre robots.txt und danach Ihre CDN- und WAF-Regeln. Notieren Sie jede Stelle, an der sie sich widersprechen, denn die Infrastruktur gewinnt.
Achten Sie bei Volumen auf Rate Limiting. Fahren Sie einen Crawl, der groß genug ist, um etwas zu bedeuten, und achten Sie auf Antworten, die erst mittendrin auftauchen statt gleich am Anfang. Ein halber Crawl ergibt ein halbes Audit und selbstsichere falsche Schlüsse.
Prüfen Sie, ob Ihre Plattform signierte Crawler-Anfragen unterstützt, und ob Ihre Audit-Tools tatsächlich signieren. Das ist der Unterschied zwischen einem Audit Ihres Shops und einem Audit des Teils Ihres Shops, den Ihre Firewall an diesem Tag ausliefern wollte.
Schreiben Sie die Richtlinie auf. Eine Seite: welche Crawler erlaubt sind, welche eingeschränkt, die Begründung und wer Änderungen freigibt. Mit Datum.
Arbeiten Sie die Punkte in dieser Reihenfolge ab. Bei überraschend vielen Shops ist die erste Prüfung schon die letzte, weil die Antwort sofort da ist und die Arbeit auf ein einziges Infrastruktur-Ticket zusammenschrumpft.
Erwartungen korrigiert
Veröffentlichen Sie llms.txt, wenn Sie möchten, mit der passenden Erwartung: Es kostet wenig, es kann agentischen Browsern und Developer-Tools dienen, und kein großes KI-Suchprodukt hat zugesagt, die Datei zu lesen. Stellen Sie sie online, halten Sie sie korrekt und geben Sie ihr keinen Platz in einem Plan für Sichtbarkeit. Websites mit viel Dokumentation und API-Produkte haben davon mehr als jeder Katalog.
Richten Sie Ihre Aufmerksamkeit lieber auf drei andere Fragen. Erreichen KI-Crawler Ihre Seiten? Tut Ihre Infrastruktur das, was Ihre Richtlinie sagt? Und hat die Frage sperren oder zulassen einen Verantwortlichen? Diese drei entscheiden, ob alles Weitere in einem KI-Suchprogramm überhaupt etwas bringt, und sie sind langweilig genug, um jahrelang ungeprüft zu bleiben. In der KI-Beratung taucht der erste echte Befund meist auf der Zugriffsebene auf, lange bevor eine Content-Frage an die Reihe kommt.
Häufig gestellte Fragen
Hilft llms.txt E-Commerce-Websites, in der KI-Suche zu erscheinen?
Dafür gibt es keinen dokumentierten Beleg. Google erklärt, dass für seine KI-Funktionen keine besonderen maschinenlesbaren Dateien nötig sind, und eine unabhängige Auswertung der Verbreitung im großen Maßstab fand keinen Effekt auf Zitate, während die meisten veröffentlichten Dateien nie abgerufen wurden. Nachweislich lesen heute Coding-Assistenten und Agent-Tools die Datei, nicht KI-Suchprodukte für Verbraucher.
Sollte ich KI-Crawler sperren, um meine Inhalte zu schützen?
Das ist eine Frage der Richtlinie, keine technische, und für einen Produktkatalog fällt der Tausch schief aus. Crawler zu sperren kann auch das Abrufen von Antworten für Käufer blockieren, die nach Ihrer Kategorie fragen, weil sich Training und Retrieval am User Agent nicht sauber trennen lassen. Was Sie auch wählen: Halten Sie es als schriftliche Entscheidung mit einer verantwortlichen Person fest, statt es einer Firewall-Regel zu überlassen.
Warum sagt meine robots.txt etwas anderes, als meine Logs zeigen?
Weil robots.txt eine Richtlinie erklärt, während Ihr CDN oder Ihre Web Application Firewall entscheidet, ob eine Anfrage ausgeliefert wird. Sicherheitsebenen weisen automatisierten Traffic häufig ab oder drosseln ihn, unabhängig davon, was robots.txt erlaubt. Lesen Sie beides und behandeln Sie das Verhalten der Infrastruktur als die echte Richtlinie, bis beide zusammenpassen.
Was ist Web Bot Auth und brauche ich das?
Es ist ein Verfahren, mit dem automatisierte Anfragen nachweisen, von welchem Agenten sie stammen, statt über einen User-Agent-String beurteilt zu werden, den jeder behaupten kann. Auf Plattformen, die das unterstützen, werden signierte Anfragen anders behandelt als unsignierte. Das zählt für Crawler, die Ihren Shop erreichen, und für Ihre eigenen Audit-Tools, die einen Crawl zu Ende bringen wollen.
Die wichtigsten Punkte
llms.txt bekommt die meiste Aufmerksamkeit und hat die geringsten Folgen für einen Produktkatalog. Google erklärt, dass für seine KI-Funktionen keine besonderen Dateien nötig sind, und eine Auswertung der Verbreitung im großen Maßstab zeigte: Die Datei verhält sich bei Zitaten wie Rauschen, nicht wie ein Signal.
Die Ebene mit Folgen ist die Infrastruktur. Eine robots.txt, die KI-Crawler zulässt, bedeutet nichts, wenn ein CDN oder eine Firewall dieselbe Anfrage abweist, und dieser Widerspruch ist eher Regel als Ausnahme.
Sperren ist Richtlinie, nicht Technik. Crawlen für Training und Crawlen für Antworten lassen sich nicht sauber trennen. Wer das eine einschränkt, nimmt einen Shop mitunter aus Antworten heraus, nach denen Käufer gerade jetzt fragen.
Fünf Prüfungen klären die Frage noch diese Woche, angefangen damit, die eigenen Seiten als KI-Crawler abzurufen. Bei vielen Shops reicht diese erste Prüfung schon, und alles wird zu einem einzigen Infrastruktur-Ticket.
Die Zugriffsebene steht selten in einem Content-Kalender, weil dabei nichts herauskommt, das man vorzeigen kann. Sie ist zugleich die einzige Ebene, auf der eine einzige ungeprüfte Regel jede andere Investition in KI-Sichtbarkeit unlesbar macht.
Verwandte Artikel


