Meer tests is niet meer omzet: zo prioriteer je Shopify CRO-experimenten

Door Robin Laseur

Shopify CRO-experimenten prioriteren, een voorbeeld uit de praktijk. Een CRO-team presenteert zijn kwartaal. Het eerste getal op de slide is het tempo: veertig experimenten live, tegen vijfentwintig het kwartaal ervoor. De slide straalt vaart uit. Dan stelt iemand de enige vraag die ertoe doet: wat deed de omzet? Het wordt stil, want het eerlijke antwoord is: vrijwel niets. De tests liepen. De omzet bleef waar hij was.
Dit is de meest gemaakte fout in eCommerce-CRO, en in de kern is het een telfout. Meer tests is niet meer omzet. Voorbij een grens die je verkeer bepaalt, levert meer testen zelfs minder omzet op. Wat een testprogramma op den duur laat groeien, is niet hoeveel experimenten je draait, maar welke je weigert te draaien. Dit artikel gaat over die discipline: waarom tempo op een gegeven moment niets meer oplevert, en hoe je een backlog zo ordent dat de tests die je live zet de paar zijn die echt geld opleveren.
Waarom meer tests niet meer omzet opleveren
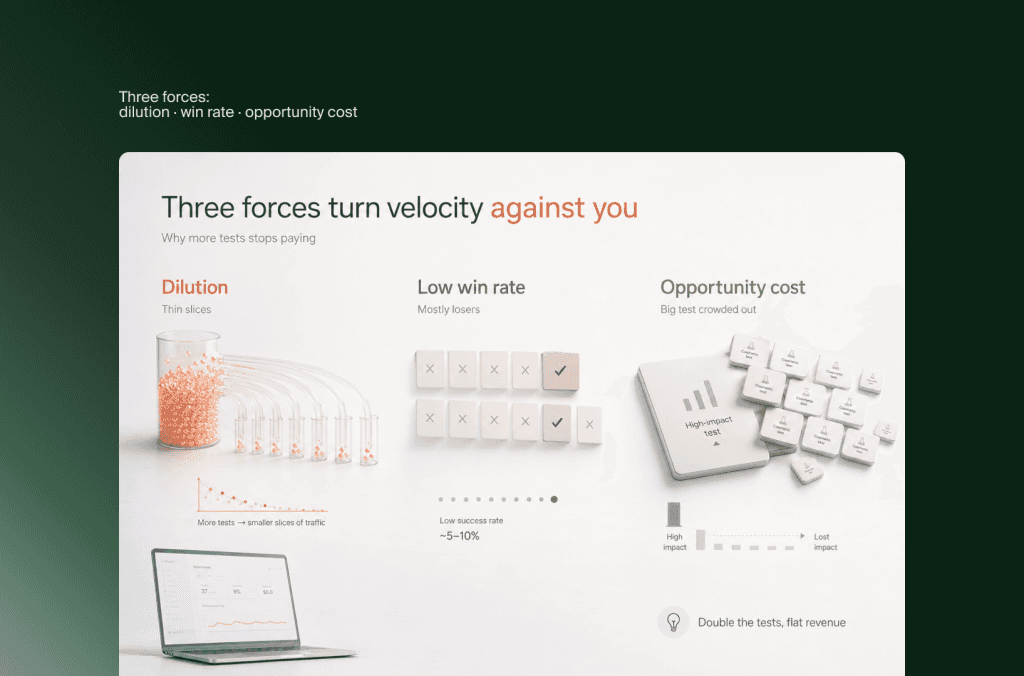
Meer tests leveren niet meer omzet op, omdat de waarde van tests heel scheef verdeeld is en statistische power eindig is. Een paar tests met grote impact leveren bijna alle winst. De meeste tests winnen helemaal niet. En elke extra test concurreert om hetzelfde beperkte verkeer dat elke test nodig heeft om significant te worden. Voorbij een grens die je verkeer bepaalt, drukt elke extra test het rendement van het programma in plaats van het te verhogen.
Drie krachten keren tempo tegen je, en de rest van dit artikel behandelt ze één voor één. De eerste is verdunning. Een webshop heeft maar zoveel sessies en conversies, en daarmee betaal je voor statistische significantie. Draai je meer tests tegelijk, dan krijgt elke test een dunnere plak en halen er minder een betrouwbare uitkomst. De tweede is het slagingspercentage, de win rate. De meeste tests winnen gewoon niet. Meer zwakke experimenten leveren vooral meer verliezers op en, erger nog, meer vals-positieven die je voor winnaars aanziet. De derde zijn de gemiste kansen. Omdat de impact zit in een handvol veranderingen die echt het verschil maken, verdringt een backlog vol kleine cosmetische tests de paar grote die er wel toe hadden gedaan.
Samen verklaren ze waarom een team het aantal tests kan verdubbelen terwijl de omzet vlak blijft. Tempo voelt als vooruitgang omdat het makkelijk te tellen is, en precies dat maakt het een vanity metric. Het programma dat blijft groeien, is niet het programma met de meeste experimenten. Het is het programma dat zijn beperkte verkeer besteedt aan zo weinig mogelijk tests met de hoogste verwachte waarde, en de discipline heeft om de rest te laten liggen. De volgende drie secties laten zien waarom dat zo werkt. De laatste gaat over hoe je kiest.
Het schaarse goed is verkeer, niet ideeën
Bijna elk Shopify CRO-programma loopt niet vast op een gebrek aan testideeën. Het loopt vast op een gebrek aan verkeer en conversies om een echte winnaar van ruis te onderscheiden. Statistische significantie is niet gratis. Je betaalt ervoor in sessies, en de meeste webshops hebben daar minder van dan hun testbacklog aanneemt.
De rekensom is meedogenloos, en het loont om hem echt te snappen. Een betrouwbare A/B-test heeft grofweg duizend conversies of meer per variant nodig, verzameld over minstens een paar weken, voordat de uitkomst iets betekent. Daarom weigeren serieuze testbureaus vaak experimenten te draaien op webshops met minder dan ongeveer vijftigduizend sessies per maand. Daaronder duurt een test maanden of wordt hij nooit significant. Draai je meerdere tests tegelijk op een kleinere webshop, dan heb je je leerwinst niet vermenigvuldigd. Je hebt je toch al schaarse verkeer verdeeld over experimenten die nu elk nog langer duren, of zonder uitkomst eindigen. Dat laatste is het duurste resultaat van allemaal: het verbruikt verkeer en levert niets op.
Wie dit negeert, krijgt een backlog die er productief uitziet en ruis oplevert. Een zwakke test op een webshop met weinig verkeer kost weken wachten op een uitkomst die statistisch wankel en commercieel onbeduidend is. Het team wil een conclusie, trekt die te vroeg of ziet een patroon in toeval. Hier zit de winner’s curse: stop je een test zodra hij even positief uitslaat, dan boek je een “winst” die geluk was. Je zet hem live en vraagt je later af waarom de totale omzet nooit optelt tot de som van al je overwinningen.
De eerste stap in prioriteren is dus niet ideeën scoren, maar eerlijk zijn over je verkeersbudget. Schat hoeveel tests je webshop in een kwartaal echt tot significantie kan brengen. Voor de meeste Shopify-webshops is dat getal klein: vaak een handvol, geen tientallen. Die ene beperking zet alles daarna in een ander licht. Kun je maar een paar tests echt draaien, dan gaat alles om de juiste keuze. Dan is de vraag wat een test een van die schaarse plekken waard maakt. Het antwoord begint bij hoe zelden tests überhaupt winnen.
De meeste tests verliezen, dus alles hangt aan de hypothese
De meeste A/B-tests winnen niet. In de hele branche ligt het aandeel experimenten met een statistisch significante verbetering op een echte commerciële metric ergens tussen een vijfde en een derde. Met strengere definities zit het dichter bij één op de tien. Dat basispercentage is het meest verhelderende feit in CRO. Het betekent dat niet het testen zelf, maar de kwaliteit van de hypothese achter een test het verschil maakt tussen een programma dat groeit en een programma dat rondjes draait.
Accepteer je dat basispercentage, dan is het mechanisme eenvoudig. Als maar een minderheid van de tests wint, dan blijf je met meer tests zonder betere selectie op hetzelfde lage slagingspercentage zitten, alleen met meer volume. Je krijgt meer verliezers en verbruikt er meer verkeer voor. De hefboom is niet volume maar een hoger slagingspercentage, en dat hangt af van bewijs. Een test die uitgaat van een echt, waargenomen probleem heeft een veel betere kans dan een test die voortkomt uit een mening in de vergaderzaal over een knop. Denk aan een checkoutstap waar sessie-opnames aarzeling laten zien, een exit survey waarin kopers een specifieke twijfel noemen, of een pagina waar analytics een scherpe daling tonen. Teams met een opvallend hoog slagingspercentage testen bijna nooit meer. Ze testen hypotheses die steunen op kwantitatieve en kwalitatieve data. Daarom kan dezelfde verandering die als gok faalt, als onderbouwde gok wel winnen.
Wie het basispercentage negeert, betaalt daarvoor, en die kosten stapelen zich ongemerkt op. Cosmetische tests, zoals een knop in een andere kleur of herschreven microcopy zonder onderbouwing, presteren gemiddeld slecht. Toch domineren ze de meeste backlogs, omdat ze makkelijk te bedenken en makkelijk te bouwen zijn. Elk van die tests kost een deel van je schaarse verkeer om een hypothese te toetsen die het gedrag waarschijnlijk nooit zou veranderen. De sterkste eCommerce-tests veranderen hoe een klant zich voelt, hoe hij beslist of hoe hij een product vindt, niet alleen hoe iets eruitziet. Dat verschil zit in het bewijs, niet in de moeite.
Wat je moet doen, volgt daar direct uit. Voordat een test een plek krijgt, moet hij over een bewijslat: welke concrete data zegt dat dit een echt probleem is, en waarom zou de voorgestelde verandering dat aannemelijk oplossen? Kan een hypothese niet op allebei antwoorden, dan is hij niet klaar om te testen. Hem toch draaien is precies hoe een programma druk blijft terwijl het slagingspercentage laag blijft. Dezelfde discipline staat centraal in de gestructureerde CRO-cycli die duurzame programma’s onderscheiden van een reeks losse experimenten.
De echte hefboom zit in de tests die je niet draait
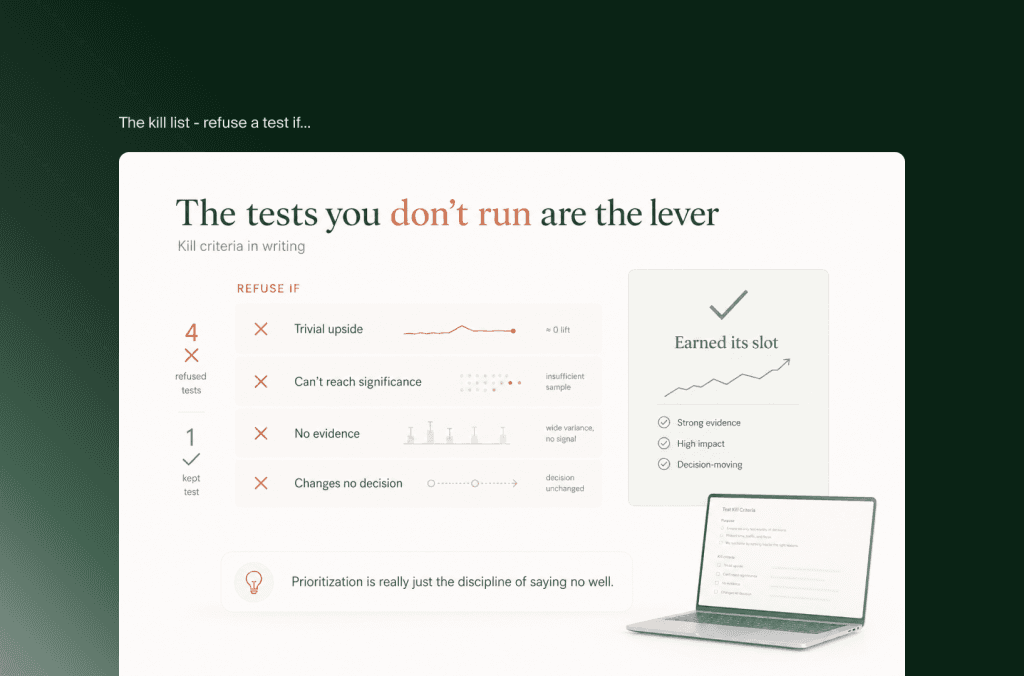
Hier komt de omslag waar dit hele artikel naartoe werkt. Omdat verkeer beperkt is en de meeste tests verliezen, is de belangrijkste beslissing in een CRO-programma niet welke tests je draait. Het is welke je weigert. Een backlog is geen takenlijst om af te werken. Het is een verzameling concurrerende claims op een schaars goed, en elke test waar je ja tegen zegt, is verkeer dat je aan alle andere tests weigert. Prioriteren is in feite de discipline om goed nee te zeggen.
Het mechanisme is gemiste kansen, verscherpt doordat impact zo scheef verdeeld is. Als een klein aantal veranderingen het grootste deel van de mogelijke winst oplevert, dan kost een test met weinig impact meer dan alleen zijn eigen zwakke uitkomst. Hij kost ook de test met grote impact die dezelfde weken verkeer had kunnen gebruiken en die kans niet kreeg, omdat een cosmetisch experiment de plek bezette. Kan een webshop maar een handvol tests per kwartaal aan, dan halveren één of twee onbeduidende tests op die plekken de echte opbrengst van het programma in die periode. Op een dashboard dat tempo meet, zie je die verspilling niet. Daar telt de onbeduidende test als een stap vooruit, niet als de gemiste winst die hij in werkelijkheid is.
Daarom weegt een lijst van wat je niet test zwaarder dan een verlanglijst. De tests die je meteen afwijst, vallen in vier herkenbare groepen. Tests waarvan de maximale opbrengst commercieel onbeduidend is, zelfs als ze winnen. Tests die met jouw verkeer niet binnen een redelijke termijn significant kunnen worden. Tests zonder ander bewijs dan een voorkeur. En tests waarvan de uitkomst geen enkele beslissing zou veranderen, wat er ook uitkomt. Een test die op één van deze punten zakt, is geen lagere prioriteit voor later. Het is een nee, en dat uitspreken beschermt het verkeer waar je paar echte gokken van afhangen. Het ongemakkelijke deel is cultureel. Het lievelingsidee van een stakeholder schrappen is moeilijker dan het stilletjes aan de backlog toevoegen. Precies daarom draaien zwakke programma’s alles en sterke niet.
Maak weigeren dus expliciet en makkelijk. Leg de afwijscriteria op papier vast, zodat een nee beleid is en geen persoonlijk oordeel. En houd vast aan het idee dat een test die je niet draait geen gebrek aan ambitie is, maar een bewuste keuze om schaars verkeer in te zetten waar het rendeert. De programma’s die uitlopen, zijn niet dapperder in testen. Ze kunnen beter leven met niet testen, en die rust is indirect de bron van hun resultaten.
Diezelfde discipline, minder tests met beter bewijs, is wat een gespecialiseerd Shopify Plus-bureau meebrengt in een CRO-retainer, in plaats van tempo na te jagen om het tempo.
Zo zet je je tests op volgorde
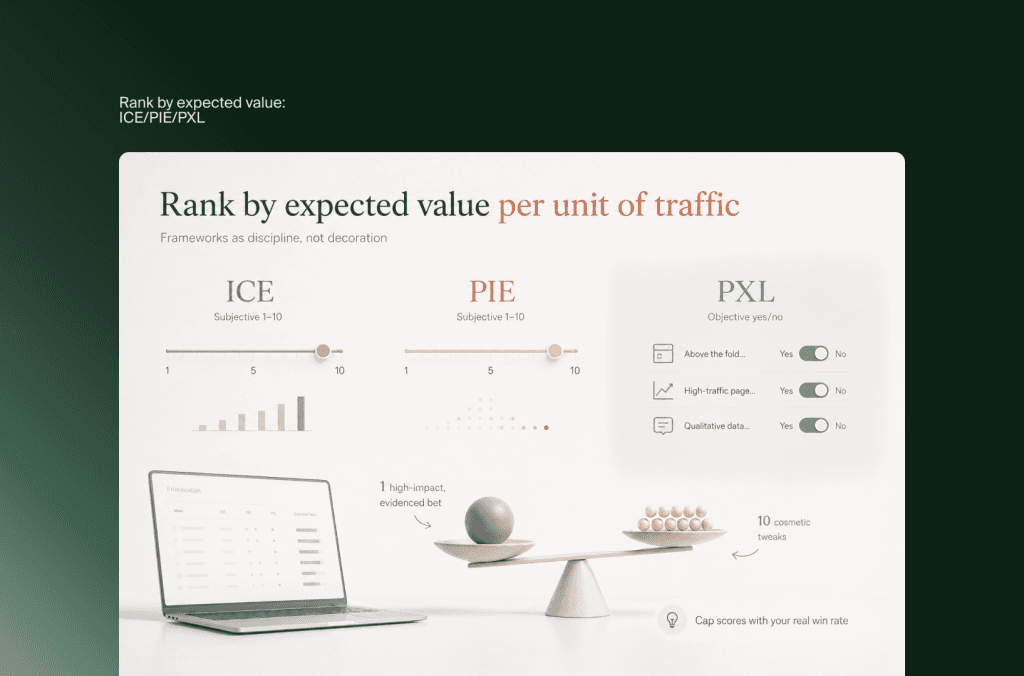
Met het verkeersbudget bekend en de afwijscriteria op papier is het ordenen van wat overblijft het makkelijke deel. Het komt neer op één idee: rangschik op verwachte waarde per eenheid verkeer, niet op hoe aantrekkelijk een idee voelt. Verwachte waarde is hier het eerlijke product van drie dingen: hoe groot de winst is als de test wint, hoe groot de kans is dat hij echt wint, en hoeveel het verkeer waard is dat hij raakt. Dat deel je door het verkeer en de tijd die de test kost om tot een uitkomst te komen. Een test met een grote mogelijke uplift op je pagina met de meeste omzet, gesteund door echt bewijs, is meer waard dan tien cosmetische aanpassingen op een pagina waar niemand iets koopt.
De bekende scoremodellen zijn nuttig, zolang je ze als discipline gebruikt en niet als versiering. ICE (Impact, Confidence, Ease) en PIE (Potential, Importance, Ease) zijn prima om mee te beginnen. Hun zwakte is dat de scores subjectief zijn, en optimisme blaast ze op tot alles een negen is. PXL, het model van het CXL-team, lost dat op door vage scores van één tot tien te vervangen door objectieve ja/nee-vragen: staat de verandering above the fold, zit ze op een pagina met veel verkeer, is er kwalitatieve data die haar ondersteunt? De waarde van deze modellen zit niet in het getal dat eruit komt. Ze dwingen je om bij elke test dezelfde eerlijke input te gebruiken: bewijs, moeite en waar het geld zit. Zo wordt de vergelijking eerlijk.
Criterium | De vraag die je stelt | Waarom dit de prioriteit bepaalt |
Waar het geld zit | Raakt dit een pagina met veel verkeer, veel omzet of veel uitval? | Een winst op een pagina die niemand bezoekt, verandert niets. De impact groeit mee met het verkeer en de omzet achter de pagina |
Sterkte van het bewijs | Welke kwantitatieve en kwalitatieve data zegt dat dit een echt probleem is? | Bewijs tilt het slagingspercentage boven het schamele basispercentage uit. Een voorkeur is geen bewijs |
Omvang van de winst | Is de opbrengst commercieel de moeite waard als de test wint? | Een statistisch echte maar onbeduidende uplift is een plek verspild aan een afrondingsverschil |
Haalbaarheid | Kan deze test met ons verkeer binnen een redelijke termijn significant worden? | Een test die niet tot een conclusie komt, is verkeer uitgegeven zonder antwoord |
Er is één eerlijke input waar de modellen op leunen en waar de meeste teams naar gissen: je eigen cijfers. Pak voor je volgende prioriteringsoverleg de uitkomsten van je laatste twintig tests erbij en bereken je echte slagingspercentage en je mediane uplift. Die cijfers vallen voor de meeste webshops bescheidener uit dan iedereen verwacht. Ze worden het plafond voor elke toekomstige impactscore. Zo haal je het optimisme uit de oefening en baseer je haar op wat je programma echt doet. Betrouwbare benchmarks voor win rate en betrouwbaarheid zijn een handige controle naast je eigen cijfers. Prioriteren is geen spreadsheetritueel. Het is de vaste keuze om schaars verkeer alleen daar in te zetten waar het verwachte rendement dat rechtvaardigt, en die keuze steeds opnieuw te toetsen aan je eigen resultaten.
Veelgestelde vragen
Hoeveel A/B-tests kan ik tegelijk draaien op Shopify? Minder dan je denkt, en dat aantal hangt af van je verkeer, niet van je ambitie. Significantie vraagt grofweg duizend conversies of meer per variant, dus de meeste Shopify-webshops kunnen maar een handvol betrouwbare tests per kwartaal aan. Draai je er meer tegelijk, dan verdeel je je verkeer en heeft elke test te weinig data. Eén goed gekozen test met een heldere uitkomst is meestal beter dan drie met een troebele.
Welk prioriteringsmodel is het beste: ICE, PIE of PXL? Het model doet er minder toe dan de eerlijkheid van de input. ICE en PIE zijn snel, maar hun subjectieve scores vallen te optimistisch uit. PXL beperkt die vertekening met objectieve ja/nee-vragen en is de betere keuze voor een serieus programma. Welk model je ook kiest, de echte taak is dat je bij elke test dezelfde vragen over bewijs en impact stelt, en dat het werkt als filter om tests af te wijzen, niet alleen als ranglijst.
Heb ik genoeg verkeer om A/B-tests te draaien op mijn Shopify-webshop? Als vuistregel: zinvol A/B-testen vraagt genoeg conversies om binnen een paar weken rond de duizend per variant te halen. Veel webshops halen dat vanaf ongeveer vijftigduizend sessies per maand. Daaronder duren tests te lang of eindigen ze zonder uitkomst. Webshops met minder verkeer zijn meestal beter af met onderbouwde veranderingen die ze direct live zetten. Testen doe je dan alleen bij de veranderingen met de grootste impact, waar een groot effect ook met kleinere aantallen zichtbaar wordt.
Wat is een goede win rate bij CRO? In de branche ligt het aandeel statistisch significante, commercieel betekenisvolle uitkomsten meestal tussen ongeveer één op de tien en één op de drie, afhankelijk van hoe streng je een winst definieert. Een hoger slagingspercentage komt meestal door betere hypotheses en sterker bewijs, niet door meer testen. Volg je eigen slagingspercentage en mediane uplift door de tijd heen. Dat is de eerlijkste maat voor de vraag of je prioritering beter wordt.
Belangrijkste inzichten
Tempo is een vanity metric. Meer tests is niet meer omzet. Voorbij een grens die je verkeer bepaalt, is het zelfs minder, omdat de waarde van tests scheef verdeeld is en statistische power eindig.
Verkeer is de beperking, niet ideeën. Significantie kost sessies, dus de meeste Shopify-webshops kunnen maar een handvol betrouwbare tests per kwartaal aan. Ken dat budget voordat je iets op volgorde zet.
Alles hangt aan de hypothese. De meeste tests verliezen. De winnaars steunen op kwantitatief en kwalitatief bewijs, niet op een mening uit de vergaderzaal. Laat elke test over de bewijslat gaan.
De echte hefboom zit in de tests die je niet draait. Prioriteren is de discipline om nee te zeggen. Leg afwijscriteria vast, zodat het schrappen van een zwakke test beleid is en geen politiek.
Rangschik op verwachte waarde per eenheid verkeer. Gebruik ICE, PIE of PXL om eerlijke input af te dwingen, en begrens je impactscores met je eigen slagingspercentage en mediane uplift.
Gerelateerde artikelen


