AI-zoekoptimalisatie voor eCommerce: het draaiboek voor GEO, AEO en agentic commerce in 2026

Door Robin Laseur

Het aantal vertoningen stijgt, het aantal kliks blijft gelijk, en bij de tweede kwartaalreview heeft iemand het tot CTR-probleem verklaard. Het probleem zit in de leidingen, en leidingen leg je in een vaste volgorde. AI-zoekoptimalisatie voor eCommerce betekent dat je je webshop leesbaar, bruikbaar en citeerbaar maakt voor de AI-systemen die koopvragen beantwoorden, nog voordat iemand een pagina met zoekresultaten ziet. Het werk bestaat uit drie lagen: toegang, productdata en reputatie. De meeste plannen die je online vindt, behandelen die lagen als losse sporen die tegelijk lopen. Ze bouwen op elkaar voort, en juist in die volgorde zit het geld.
Hieronder staat het werkplan: welke laag je eerst onderzoekt, wat elk geval echt vraagt, wie de eigenaar is, en op welk punt agentic commerce geen contentvraag meer is, maar een vraag of je wordt toegelaten.
Wat AI-zoekoptimalisatie voor eCommerce in 2026 inhoudt
Het vak bestaat uit drie lagen. Toegang: kunnen AI-crawlers en agents je pagina’s en je catalogus überhaupt bereiken? Productdata: is wat ze vinden volledig genoeg om te matchen met de eisen van een klant? Reputatie: beschrijven andere bronnen op het web je merk zoals jij het zelf zou beschrijven? Elke laag heeft een andere eigenaar en andere tools.
De afkortingen liggen nog niet vast en zijn grotendeels inwisselbaar. Bij GEO (generative engine optimization) maak je content zo dat hij wordt gebruikt in gegenereerde antwoorden. Bij AEO (answer engine optimization) maak je content zo dat hij zelf het antwoord is. AIO slaat meestal op de AI Overviews van Google, en dat is één kanaal tussen meerdere, niet het hele vakgebied. Kies intern één term en hou je eraan. De discussie over woorden kost vergaderingen die je beter aan je catalogus kunt besteden.
Voor een middelgroot merk tellen minder kanalen mee dan de discussie over afkortingen doet vermoeden: Google AI Overviews en AI Mode, ChatGPT, Microsoft Copilot, Perplexity en Gemini. Rufus van Amazon leest een catalogus die je ergens anders beheert, dus die valt buiten dit plan. Een deel van deze kanalen leest een gestructureerde productfeed. Ze lezen allemaal je pagina’s. Die splitsing bepaalt welk team het werk doet, en daarom benoem je in de praktijk de lagen en niet de afkortingen.
De volgorde is precies het punt dat de meeste adviezen overslaan. Een merk met uitstekende reviews en een firewall die AI-crawlers een 403 teruggeeft, is onzichtbaar, en daar verandert geen outreach naar publishers iets aan. Een merk met schone toegang en lege productattributen wordt wel gecrawld, maar daarna overgeslagen. Een systeem dat zoekt op “waterdicht, onder €150, op voorraad in Nederland” kan niets matchen met lege velden. Reputatiewerk levert pas iets op als de twee lagen eronder staan. Ons eerdere stuk over GEO voor commerce gaat dieper in op de definities. Dit stuk gaat over de volgorde.
Begin hier: welke laag je zichtbaarheid kost
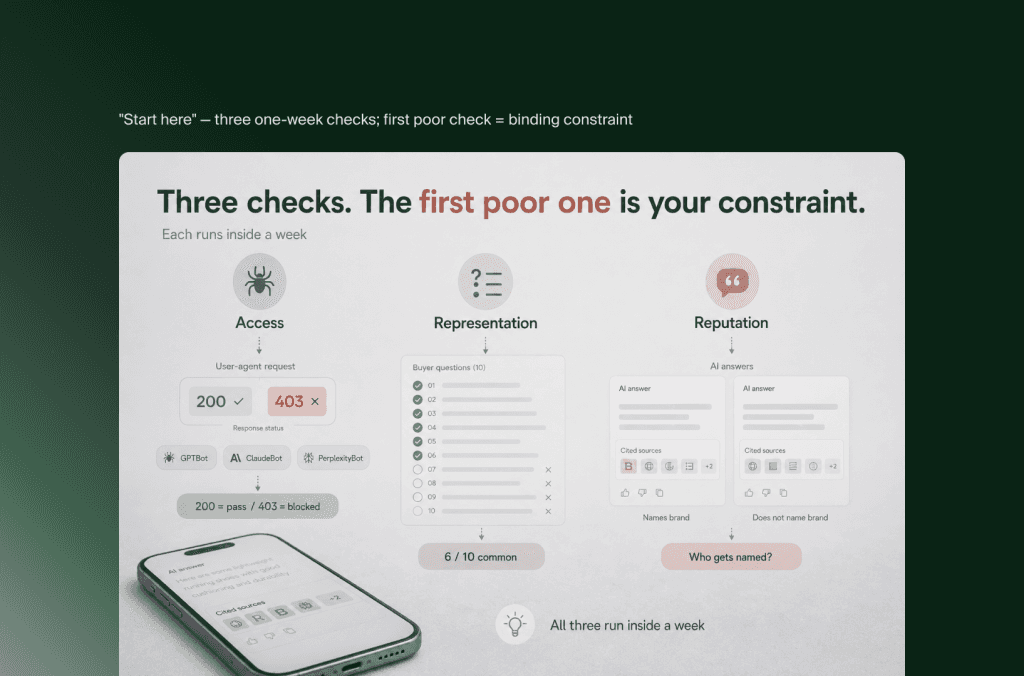
Drie checks maken onderscheid tussen de lagen, en alle drie passen in één week. Vraag een pagina op met de user agent van een AI-crawler en kijk naar de responscode. Lees één productpagina met de vragen erbij die een klant stelt voordat hij koopt. Test tien prompts binnen je categorie op twee AI-platforms en noteer wie er genoemd wordt. De eerste check die slecht uitvalt, is je knelpunt.
De toegangscheck. Vraag een productpagina en een collectiepagina op als GPTBot, OAI-SearchBot, ClaudeBot en PerplexityBot. Een 200 met volledige HTML betekent geslaagd. Krijg je een 403, een 429 of een bijna lege respons, dan heb je je antwoord. Die komt meestal van het CDN of de firewall, niet van robots.txt. Noteer de datum en de responscodes: dit is de nulmeting waarmee je later vergelijkt.
De productdatacheck. Neem de productpagina met de meeste omzet en schrijf de tien vragen op die een koper stelt voor de checkout: maat, pasvorm, materiaal, onderhoud, compatibiliteit, levertijd, retourvoorwaarden en drie vragen die specifiek zijn voor jouw categorie. Tel hoeveel ervan op de pagina beantwoord worden in gewone tekst die een systeem kan uitlezen. Zes van de tien is gebruikelijk. Zit je daaronder, dan verklaart dat een groot deel van de aanbevelingen die je misloopt.
De reputatiecheck. Test tien prompts met koopintentie binnen je categorie op twee AI-platforms. Noteer per prompt drie dingen: wordt je merk genoemd, wordt een pagina van jou geciteerd, en op welke bronnen leunt het antwoord in plaats daarvan. Die laatste kolom is de nuttigste helft van de steekproef, want daar staan de kanalen waarop je concurreert.
Teams beginnen meestal bij laag drie. Dat is het zichtbaarste werk, het levert de mooiste slides op en het is het makkelijkst uit te leggen aan de directie. Het is ook het traagste en duurste van de drie. In de AI-consultancytrajecten van Flatline begint de volgorde die in een echt team overeind blijft bij de check met het duidelijkste probleem. Niet bij de laag waar de meeste congrespresentaties over gaan.
Geval A: als AI-systemen je webshop niet kunnen bereiken
De toegangslaag bestaat uit je robots.txt, je CDN-regels, je web application firewall en, op Shopify, de botauthenticatie die bepaalt welke geautomatiseerde verzoeken als legitiem gelden. Beleid en praktijk lopen hier vaker uiteen dan teams denken. Een robots.txt die GPTBot toelaat, zegt weinig als de beveiligingslaag ervoor hetzelfde verzoek met een 403 beantwoordt.
Het symptoom duikt al vroeg op in technisch werk. Grote crawls van Shopify-webshops lopen vast op 429-responses. In een rapport lijkt dat een contentprobleem, maar het zit in de beveiligingslaag. Sinds augustus 2025 ondersteunt Shopify ondertekende crawlerverzoeken via Web Bot Auth, en een geldige handtekening is het verschil tussen een volledige en een halve audit. Onze uitleg over Screaming Frog op Shopify beschrijft die configuratie in detail.
Over llms.txt moet je eerlijk zijn. Zo’n bestand publiceren kost een middag, en geen enkele grote zoekmachine heeft publiek toegezegd het te volgen als instructie voor het ophalen van content. Zie het als een goedkope gok met een onbewezen opbrengst, niet als oplossing voor iets op deze lijst.
De grotere beslissing in dit geval is een beleidskeuze in technische vermomming. Als je AI-crawlers blokkeert, houd je je content uit trainingsdata en verdwijn je tegelijk uit gegenereerde antwoorden. Die twee doelen trekken tegen elkaar in, en geen developer zou dat om vier uur ’s middags in een firewallregel moeten beslissen. Iemand met zeggenschap over het merk moet opschrijven welke crawlers welkom zijn en waarom. Eén pagina is genoeg. Juist die geschreven versie voorkomt dat het beleid verschuift telkens als een standaardinstelling van het CDN verandert.
Geval B: als systemen je webshop kunnen lezen, maar niets met je data kunnen
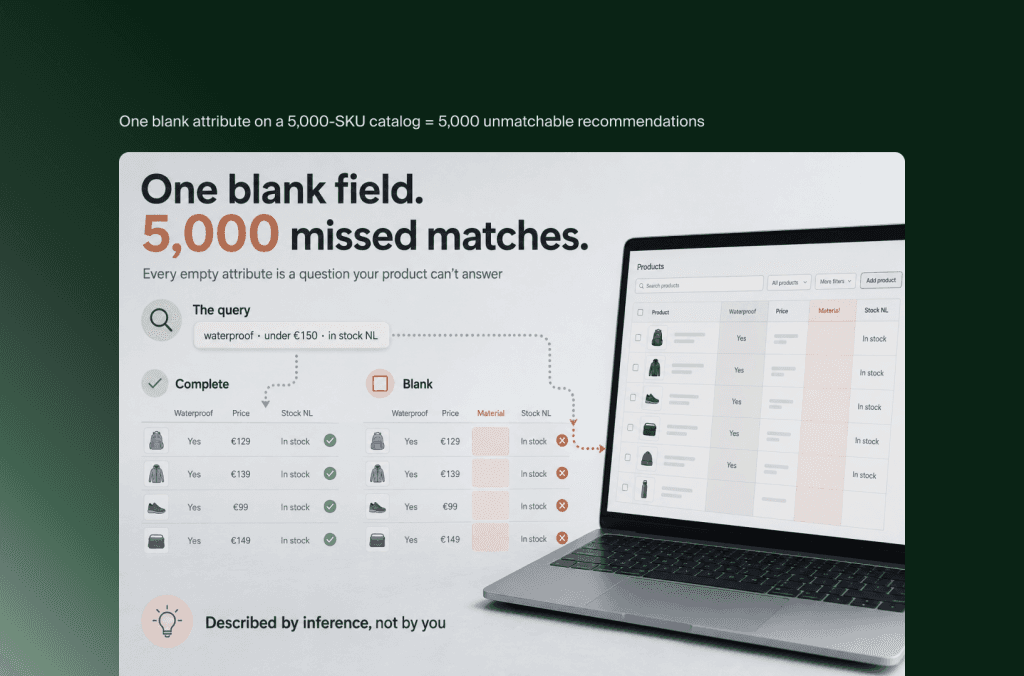
Bij productdata draait alles om volledigheid. AI-systemen leggen producten naast de eisen van een klant, dus elk leeg attribuut is een vraag waarop je product geen antwoord heeft: GTIN, merk, materiaal, maat, gewicht, beschikbaarheid, compatibiliteit. Dunne productteksten en onvolledige structured data komen via een andere route op hetzelfde uit: een product dat nooit op de shortlist belandt.
Drie dingen wegen het zwaarst. Structured data in al je templates (minimaal Product- en Review-markup, FAQPage waar echt een set vragen bestaat) geeft systemen de feiten kant-en-klaar, die ze anders uit de opmaak zouden moeten afleiden. Volledige attributen in de catalogus bepalen of een zoekvraag vol eisen jou überhaupt kan vinden. Antwoorden op vragen van voor de aankoop, in de tekst van de pagina zelf en niet in een afbeelding of een tab die pas na een klik laadt, bepalen of die match de vervolgvraag van de klant overleeft.
Er is een tweede effect dat je moet begrijpen voordat iemand gaat discussiëren over de lengte van teksten. Shopify Catalog leidt extra productattributen af uit transactiesignalen op het hele platform. Een onvolledige catalogus wordt dus toch beschreven aan AI-kanalen, alleen niet door jou, maar op basis van afleiding. Bij een catalogus van 5.000 SKU’s is één leeg attribuut geen kleine omissie. Het zijn 5.000 aanbevelingen waarin de eis van een koper niet aan jouw product gekoppeld kan worden, en dan is de afgeleide versie van je product degene die meedoet.
In welke volgorde je veld voor veld implementeert, over templates en varianten heen, is een project op zich. Dat hoort in een bouwticket, niet in een strategiedocument. Op planniveau is de beslissing kleiner: welke SKU’s je eerst aanvult. Op volgorde van omzet, niet van het alfabet.
Geval C: als het antwoord iedereen citeert behalve jou
Reputatie is de laag waarin bronnen buiten jouw invloed je producten beschrijven. Gegenereerde antwoorden worden samengesteld uit reviews, vergelijkingen van publishers, discussies binnen je categorie en gestructureerde merkgegevens die verspreid staan over profielen en bedrijvengidsen. Over geen laag wordt meer geschreven, en voor geen laag bestaat minder advies over de volgorde. Daarom houden we dit deel kort en de indeling concreet.
Vijf kanalen leveren de meeste citaties op voor eCommerce-merken:
Reviews op je eigen productpagina’s, want die leveren de praktijkdetails waar gegenereerde antwoorden naar grijpen als een vraag een eis bevat zoals “voor brede voeten” of “voor een bruiloft op het strand”.
Reviewplatforms van derden, waar het aantal reviews en hoe recent ze zijn zwaarder wegen dan de score.
Overzichtsartikelen en vergelijkingen van publishers, die onevenredig vaak geciteerd worden omdat ze al als aanbeveling zijn opgebouwd.
Discussies over je categorie op Reddit, YouTube en gespecialiseerde fora, want daar staat wat mensen vinden zonder dat een merk meepraat.
Consistente merkgegevens in profielen en bedrijvengidsen, zodat je merknaam, categorie, land en productlijnen overal hetzelfde luiden waar een systeem ze controleert.
Auteurs met naam en aantoonbare expertise horen ook bij deze laag. Een pagina met een echte auteur, een echte kwalificatie en een datum behandelt een systeem makkelijker als bron dan dezelfde tekst zonder naam. Begin met in kaart brengen welke bronnen nu geciteerd worden bij je tien prompts. Outreach zonder die kaart is gokken met een budget.
Waar agentic commerce het plan verandert, en waar toelating het stopzet
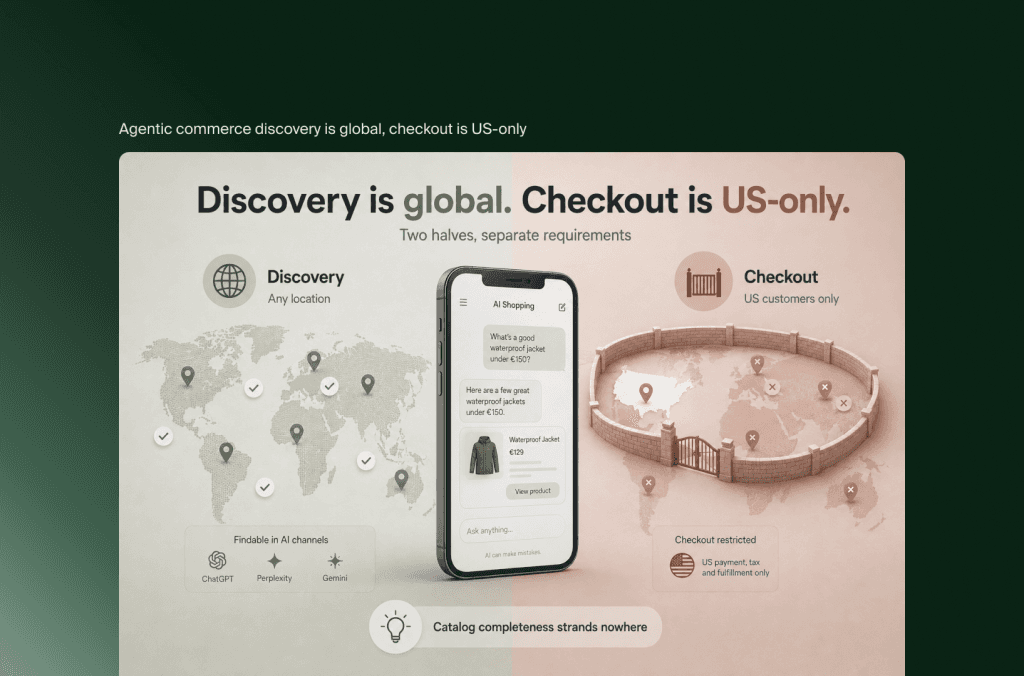
Agentic commerce bestaat uit twee helften die vaak als één worden besproken. Vindbaarheid en checkout stellen verschillende eisen. Producten kunnen in AI-kanalen gevonden worden zonder dat de webshop iets hoeft te doen, terwijl de ingebouwde agentic checkout alleen wordt getoond aan klanten in de Verenigde Staten. Dat staat in de eigen documentatie van Shopify over de voorwaarden. Voor een Europees merk gooit die ene regel het plan om. Het werk aan je catalogus betaalt zich vandaag al volledig terug via vindbaarheid, en het werk aan de checkout wacht op toelating.
Het is eerder papierwerk dan techniek. Agentic Storefronts draaien op Shopify Catalog, webshops die in aanmerking komen zien hun deelnemende kanalen in de Shopify-admin, en voor toegang moet je de aanvullende voorwaarden voor Agentic Storefronts accepteren. Shopify bepaalt naar eigen inzicht wie in aanmerking komt. De kanalen gedragen zich onderling anders, en dat maakt in de praktijk verschil. Verkopen via ChatGPT worden afgerond in de checkout van je eigen webshop, dus de beperkingen die gelden voor ingebedde checkouts spelen daar niet. Ons stuk over de Shopify agentic storefront loopt de inrichting stap voor stap door, voor teams die zover zijn.
Wat dit betekent voor meten, missen de meeste plannen. Bepaalde Shopify-functies, waaronder custom pixels, worden op sommige agentic kanalen niet ondersteund. Bestellingen kunnen dus binnenkomen met kanaalattributie in Shopify, terwijl je client-side tracking niets laat zien. Het eerste eerlijke rapport over agentic verkoop komt daarom uit het overzicht Bestellingen, niet uit je analytics-dashboard. Teams die daar pas na een kwartaal rapporteren achter komen, concluderen vaak dat het kanaal niets heeft opgeleverd.
Wat het agentic plan van een Europees merk tegenhoudt, is dus geografie, niet technische gereedheid. Dat is gunstiger dan het klinkt, want alles uit geval B is voorwerk voor beide helften. Een volledige catalogus levert nu vindbaarheid op en voldoet later aan de eisen voor de checkout. Daarmee is het de enige investering in dit artikel die door geen enkele verandering in toelating waardeloos kan worden.
Weet je niet waar je moet beginnen? De standaardvolgorde voor 90 dagen
Komen alle drie de checks middelmatig terug, hou dan deze volgorde aan: toegang in week één en twee, productdata voor je vijftig SKU’s met de meeste omzet in week drie tot en met acht, en reputatie vanaf week zes. Leg een gedateerde nulmeting vast voordat je iets verandert. Dit is de veilige standaard, omdat een toegangsblokkade elke latere meting onleesbaar maakt.
Wees eerlijk over wat meten op dit moment kan. Een nulmeting kun je vandaag leggen voor: prompttests op een vaste set vragen, verwijzingsverkeer uit AI-tools als apart segment in je analytics, en kanaalattributie in Shopify Bestellingen. Wat je nog niet betrouwbaar kunt herleiden, is de weg van een merkvermelding in een gegenereerd antwoord naar een specifieke bestelling. Een vermelding zonder klik laat geen sessie en geen pixel-event achter. Rapporteer de eerste groep maandelijks en noem de tweede groep richtinggevend. Wie die tweede groep als oorzaak presenteert, raakt het budget het snelst kwijt zodra iemand de claim toetst.
In al onze trajecten zien we hetzelfde: deze plannen breken bij de overdracht, niet bij de tactiek. Toegang ligt bij een developer, attributen bij merchandising, antwoorden bij content en outreach bij marketing. Vier eigenaren, één volgorde, en niemand die alle vier de kolommen overziet. De eigenaarskolom in de tabel hierboven doet meer werk dan je zou denken.
Veelgestelde vragen
Is gewone SEO nog belangrijk voor AI-zoekmachines?
Ja, en het blijft de basis. Crawlbaarheid, canonical-structuur, laadsnelheid en interne links bepalen of AI-systemen je pagina’s überhaupt kunnen ophalen. Klassieke zoekmachines leveren bovendien nog steeds het meeste eCommerce-verkeer. Zie AI-zoekoptimalisatie als een extra laag bovenop een technische basis die werkt, niet als vervanging ervan.
Heb je een llms.txt-bestand nodig?
Publiceren kost weinig, en geen enkele grote AI-zoekmachine heeft publiek toegezegd het te volgen als instructie voor het ophalen van content. Zet er een online als dat je een middag kost, en verwacht er niets meetbaars van. Het is geen vervanging voor toegang voor crawlers of voor volledige productdata. Dat zijn de twee dingen die aantoonbaar iets veranderen.
Hoe lang duurt het voordat dit werk resultaat oplevert?
Herstelde toegang zie je binnen een paar dagen terug, omdat crawlers snel terugkomen zodra de responses veranderen. Werk aan catalogus en content wordt meestal binnen vier tot acht weken zichtbaar, naarmate pagina’s opnieuw worden opgehaald. Reputatiewerk beweegt per kwartaal. Leg eerst een gedateerde nulmeting vast, anders is de verbetering niet te onderscheiden van de normale schommelingen in gegenereerde antwoorden.
Kan een webshop buiten de VS verkopen via agentic commerce?
Producten van webshops die in aanmerking komen, zijn overal in AI-kanalen te vinden, maar de ingebouwde agentic checkout van Shopify wordt alleen getoond aan klanten in de Verenigde Staten. Een Europees merk maakt dus nu het werk aan catalogus en attributen af, want dat levert direct vindbaarheid op. Het activeren van de checkout is een latere stap, die afhangt van de vraag wanneer de toelating wordt uitgebreid.
De belangrijkste punten
De drie lagen hebben een vaste volgorde. Eerst toegang, dan productdata, dan reputatie. Geld voor reputatie rendeert pas als de twee lagen eronder al staan.
Eerst de diagnose, dan pas het recept. Eén crawlerverzoek, één productpagina naast echte koopvragen gelegd en tien prompts getest op twee platforms vertellen je in welk geval je zit.
Beleid over toegang voor AI-crawlers hoort op papier, met als eigenaar iemand die over het merk beslist. Blokkeren beschermt je content en haalt je in dezelfde beweging uit de antwoorden.
Een volledige catalogus is de enige investering die door geen verandering in toelating waardeloos wordt. Hij levert merken waar dan ook nu vindbaarheid op, en voldoet aan de eisen voor agentic checkout overal waar die beschikbaar komt.
De volgorde in dit draaiboek is geen voorkeur. Zo werken de lagen nu eenmaal op elkaar in. Een team dat deze week de drie checks doet, bij elke stap de eigenaar noteert en de nulmeting dateert, weet volgend kwartaal welk van deze drie gevallen de zichtbaarheid echt tegenhield. Dat is een ander gesprek dan het gesprek dat begint bij een vlakke CTR-grafiek.
Gerelateerde artikelen


