Das KI-Sichtbarkeits-Audit: Wo Ihre Marke in ChatGPT, AI Overviews und Perplexity steht

Von Robin Laseur

Die meisten veröffentlichten KI-Sichtbarkeits-Audits enden mit einer einzigen Zahl zwischen null und hundert. Von allem, was so ein Audit hergibt, ist diese Zahl das am wenigsten Brauchbare: Sie schiebt zwei getrennte Fragen ineinander, und hinter beiden steckt völlig unterschiedliche Arbeit. Was KI-Systeme heute über Ihre Marke sagen, ist das eine Audit. Ob Ihre Website ihnen überhaupt etwas Brauchbares liefert, ist das andere. Eine Marke kann beim ersten Punkt schlecht abschneiden und beim zweiten gut dastehen, und danach sieht die Arbeit in beiden Fällen anders aus.
Das ist die Version, die wir als Ausgangsmessung fahren: ein festes Prompt-Set, drei Durchläufe pro Plattform, drei getrennt bewertete Achsen und vier Situationen, die jeweils in eine andere Richtung führen. Sie kostet einen Tag konzentrierte Arbeit und kein bezahltes Tool. Am Ende steht ein Benchmark mit Datum: belastbar genug für die Geschäftsleitung und konkret genug, um ihn in neunzig Tagen zu schlagen.
Was dieses Audit beantwortet und was nicht
Das Antwort-Audit misst, was generierte Antworten heute sagen: ob Ihre Marke bei den Fragen Ihrer Käufer genannt wird, ob die Beschreibung stimmt und aus welchen Quellen die Antwort schöpft. Es sagt Ihnen, wo Sie stehen.
Das Website-Audit misst, ob KI-Systeme Ihre Seiten erreichen und lesen können: Crawler-Zugriff, Rendering, Vollständigkeit der Produktdaten, strukturierte Daten. Es sagt Ihnen, warum. Flatline veröffentlicht eine kostenlose KI-Readiness-Analyse, die genau diese Seite prüft und einen bewerteten Bericht mit einer geordneten Liste an Maßnahmen zurückgibt. Das passt gut zu dem, was hier folgt.
Nur das Website-Audit liefert eine Liste technischer Aufgaben, ohne Beleg dafür, welcher Punkt tatsächlich bremst. Nur das Antwort-Audit liefert ein Urteil ohne Erklärung. Die Reihenfolge, die funktioniert: erst die Antwortseite, denn sie zeigt, welcher technische Befund wirklich zählt, danach die Seitenprüfung, um die Lücke zu erklären.
Noch eine Abgrenzung, bevor Sie anfangen. Dieses Audit liefert einen Benchmark, keine Prognose. Generierte Antworten fallen bei jedem Durchlauf anders aus, deshalb ist das ehrliche Ergebnis eine Spannweite mit Datum und kein exakter Wert.
Das Messinstrument bauen
Zwanzig bis vierzig Prompts, von Ihnen geschrieben, in der Sprache Ihrer Käufer. Ein generiertes Prompt-Set ist schneller fertig und weniger wert, denn genau dieses Instrument muss über Quartale hinweg gleich bleiben.
Ziehen Sie sie aus vier Quellen. Ihre Suchanfragen, für die Fragen, die Menschen ohnehin schon formulieren. Ihre Gespräche aus Vertrieb und Support, für die Bedingungen, die Käufer tatsächlich nennen. Die Vergleichssprache Ihrer Kategorie, denn bei Vergleichsfragen fallen die Empfehlungen. Und Ihren eigenen Markennamen, um zu prüfen, was die Systeme über Sie sagen, wenn man direkt fragt.
Decken Sie vier Prompt-Typen ab, ungefähr in dieser Verteilung:
Kategorie-Empfehlung (etwa die Hälfte): „bestes [Produkttyp] für [Einsatzzweck]“, mit den Bedingungen, die Ihre Käufer wirklich anlegen, inklusive Preisklassen und konkreten Umständen.
Vergleich (etwa ein Viertel): Ihre Marke gegen einen namentlich genannten Wettbewerber, und Alternativen zu diesem Wettbewerber.
Eigenschaft und Eignung (etwa ein Fünftel): „ist [Material oder Funktion] gut für [Situation]“, die Fragen, die einen Kauf entscheiden statt ihn zu eröffnen.
Marke direkt (der Rest): Was ist Ihr Unternehmen, was verkauft es, für wen ist es.
Frieren Sie das Set ein und versehen Sie es mit einer Versionsnummer. Jeder spätere Vergleich hängt daran, dass diese Datei unverändert bleibt.
Das Messprotokoll
Vier Regeln, und die dritte lassen die meisten Audits weg.
Wählen Sie drei Plattformen und halten Sie fest, welche. Google AI Overviews und AI Mode, ChatGPT sowie Perplexity, Gemini oder Copilot, je nachdem, wo Ihre Käufer wirklich unterwegs sind. Mehr Plattformen bedeuten mehr Arbeit, ohne dass die Ausgangsmessung schärfer wird.
Arbeiten Sie in einer sauberen Sitzung. Ausgeloggt oder in einem frischen Profil, mit dem Standort auf Ihrem wichtigsten Markt. So messen Sie das System und nicht Ihre eigene Historie.
Stellen Sie jeden Prompt dreimal pro Plattform. Das ist der Unterschied zwischen einer Messung und einem einzelnen Griff in einen schwankenden Prozess. Notieren Sie alle drei Ergebnisse, nicht das beste.
Datieren Sie alles und halten Sie die Quellen fest. Speichern Sie pro Antwort, welche Marken genannt wurden, in welcher Reihenfolge und auf welche URLs sich die Antwort gestützt hat. Die Quellenspalte liefert die Daten, mit denen Sie am schnellsten etwas anfangen können.
Der Bewertungsbogen
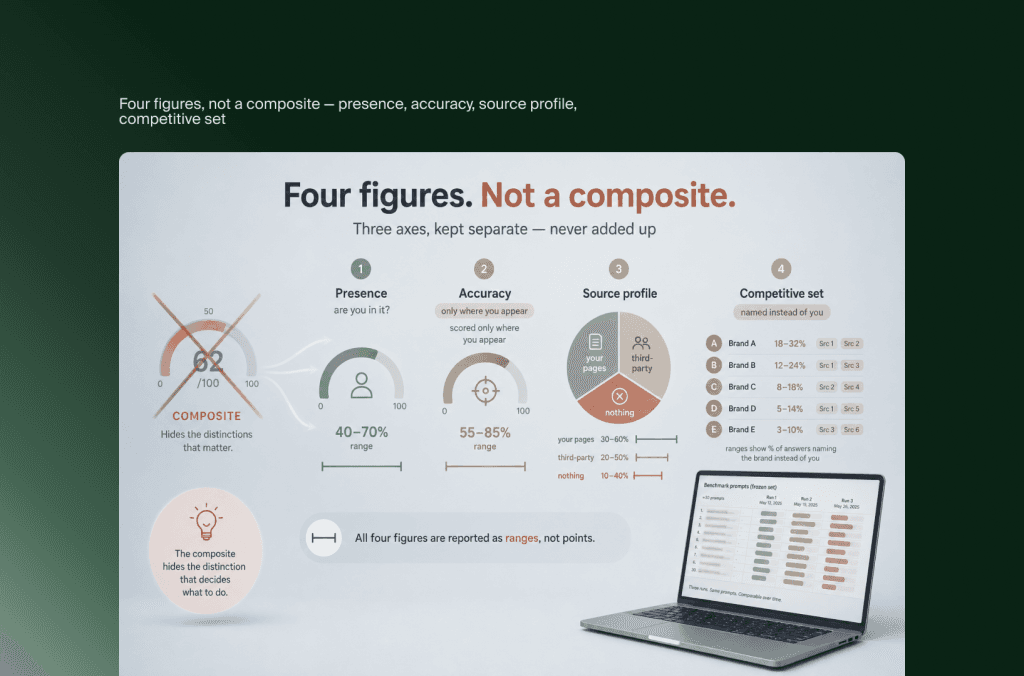
Bewerten Sie jeden Prompt auf drei Achsen. Halten Sie sie getrennt und rechnen Sie sie nicht zu einem Gesamtwert zusammen.
Erstellen Sie daraus vier Kennzahlen, jeweils als Durchschnitt über Ihr gesamtes Prompt-Set, mit der Spannweite über die Durchläufe daneben.
Durchschnittliche Präsenz, die beantwortet, ob Sie überhaupt im Gespräch vorkommen.
Durchschnittliche Genauigkeit, nur auf Prompts bewertet, in denen Sie vorkamen, die beantwortet, ob dieses Vorkommen Ihnen auch nützt.
Quellenprofil, das zeigt, ob Empfehlungen auf Ihren eigenen Seiten ruhen, auf Dritten oder auf etwas, das nichts mit Ihnen zu tun hat.
Wettbewerbsumfeld, also die drei bis fünf Marken, die am häufigsten an Ihrer Stelle auftauchen, und die Quellen, die dort zitiert wurden.
Vier Zahlen statt einer. Der Gesamtwert, den die meisten Audits berichten, verdeckt genau den Unterschied, der bestimmt, was als Nächstes zu tun ist.
Vier Situationen, und wie Sie Ihre erkennen
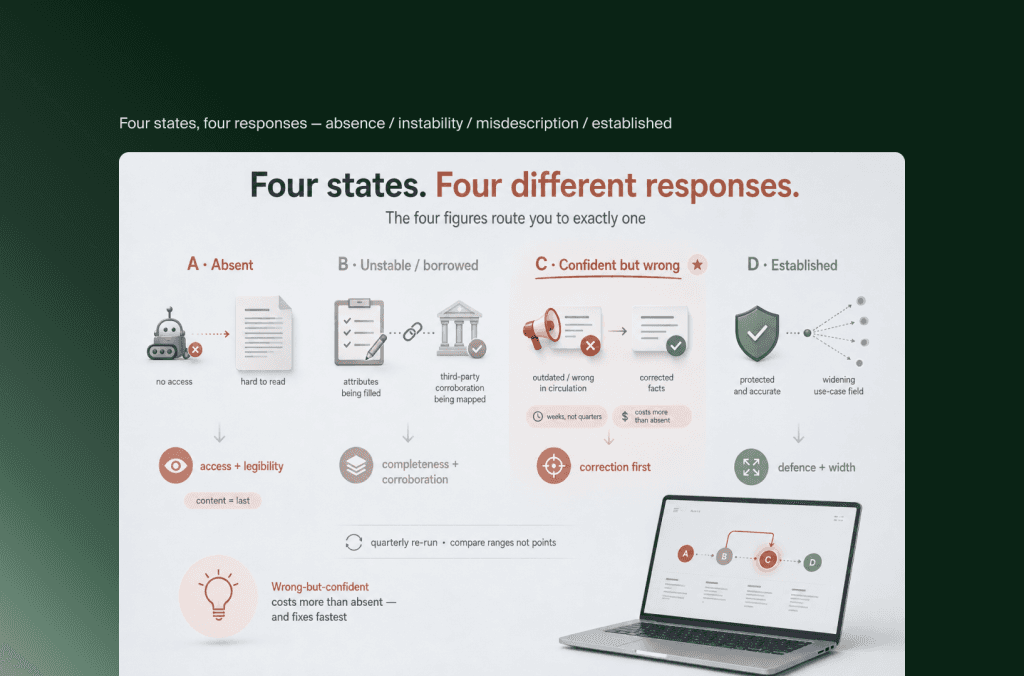
Situation C verdient eine eigene Anmerkung, weil sie Teams überrascht. Eine selbstbewusste, aber falsche Beschreibung, die durch generierte Antworten wandert, kostet mehr als gar nicht genannt zu werden: Ein Käufer handelt danach, kommt mit der falschen Erwartung an, und die Rechnung für die Korrektur landet bei Ihrem Support. Zugleich ist das meist die schnellste der vier Situationen, denn die Ursache ist häufiger veraltete öffentliche Information als eine strukturelle Lücke.
Grenzfälle
Drei Fälle liegen zwischen zwei Situationen, und alle drei lösen sich auf dieselbe Weise auf.
Stark auf einer Plattform, abwesend auf einer anderen
Bewerten Sie sie getrennt, statt zu mitteln. Ein Unterschied zwischen Plattformen ist ein Befund und kein Rauschen: Meist liest das eine System Ihre Website, während das andere sich auf fremde Quellen stützt, in denen Sie fehlen.
Präsent, aber zitiert werden nur fremde Quellen
Behandeln Sie das als Situation B, unabhängig von der durchschnittlichen Präsenz. Sichtbarkeit, die vollständig auf fremden Seiten ruht, ist echt und geliehen zugleich, und sie verschiebt sich, sobald deren Inhalte sich verschieben.
Überall korrekt, nur nicht bei Preis und Verfügbarkeit
Das ist kein Content-Problem. Wenn Preis und Verfügbarkeit auseinanderlaufen, widersprechen sich Ihre strukturierten Daten, Ihr Feed und Ihre Seite. Das ist eine Aufgabe für den Datenabgleich und keine für die Sichtbarkeit.
Was jede Situation verlangt
Situation A
Beginnen Sie bei Zugriff und Lesbarkeit, in dieser Reihenfolge. Prüfen Sie, ob KI-Crawler auf Produkt- und Kategorie-Templates vollständige Antworten erhalten, denn eine halbe Antwort erzeugt genau dieses Ergebnis, ganz leise. Prüfen Sie danach, ob Ihre Seiten die Produktfakten im Fließtext nennen und sie nicht in Tabs, Bildern und Variantenauswählern verstecken. Content zu produzieren ist hier der letzte Schritt, nicht der erste.
Situation B
Vollständigkeit und Bestätigung von außen. Füllen Sie die Produktattribute bei den umsatzstärksten SKUs, denn wenn Ihre Produkte nur halb zu den Bedingungen der Käufer passen, erscheinen Sie auch nur halb. Kartieren Sie parallel, welche fremden Quellen die Antworten zitieren, und beginnen Sie die langsame Arbeit, dort aufzutauchen.
Situation C
Zuerst korrigieren. Finden Sie heraus, wo die falsche Information steht: auf Ihren eigenen veralteten Seiten, in alten Profilen bei Dritten oder in Verzeichniseinträgen, die seit einem Rebranding niemand angefasst hat. Sorgen Sie dafür, dass die aktuellen Fakten leicht zu finden sind und überall gleich lauten. Das ist oft eine Sache von Wochen und nicht von Quartalen.
Situation D
Verteidigen und verbreitern. Erweitern Sie das Prompt-Set auf angrenzende Einsatzzwecke, beobachten Sie, ob Wettbewerber Sie bei bestimmten Bedingungen verdrängen, und halten Sie das Quellenprofil gesund, damit Ihre Position nicht auf der Liste eines einzigen Publishers ruht.
Wiederholen Sie das gesamte Audit jedes Quartal, gegen dasselbe eingefrorene Prompt-Set, und vergleichen Sie Spannweiten statt Punktwerte. Eine durchschnittliche Präsenz, die von 0,9 auf 1,4 steigt, während sich die Spannweiten überlappen, ist ermutigend und noch kein Beweis; derselbe Sprung mit getrennten Spannweiten ist ein Ergebnis.
Was wir bewusst weggelassen haben
In dieser Methode stehen keine Benchmark-Prozente, und das ist eine Entscheidung. Die kursierenden Zahlen dazu, was eine gesunde Nennungsrate sei, stammen aus Anbieterstudien mit unveröffentlichten Prompt-Sets, und ein Benchmark, den Sie nicht reproduzieren können, ist kein Benchmark. Ihr erster datierter Durchlauf ist Ihre Ausgangsmessung. Die gilt es zu schlagen.
Auch kein Gesamtwert, aus dem Grund, der oben steht: Die Zahl, die eine Folie entschlossen aussehen lässt, ist genau die Zahl, die Ihnen die Information nimmt, die Sie zum Handeln brauchen.
Wenn Sie das Instrument lieber nicht selbst bauen: Das ist die Ausgangsmessung, die Flatline zu Beginn eines GEO-Projekts fährt. Wir sind Shopify Platinum Partner mit einem Team für KI-Beratung und technisches SEO. Sie erhalten einen Benchmark mit Datum, die vier Kennzahlen, Ihr Wettbewerbsumfeld samt zitierter Quellen und einen nach Priorität geordneten Maßnahmenplan, zugeschnitten auf die Situation, in der Sie landen. Fordern Sie das Audit an, dann fahren wir die Ausgangsmessung und gehen mit Ihnen durch, was sie für Ihr Sortiment bedeutet.
Häufig gestellte Fragen
Wie lange dauert ein KI-Sichtbarkeits-Audit?
Ein Tag konzentrierte Arbeit für ein Set aus zwanzig bis vierzig Prompts auf drei Plattformen mit je drei Durchläufen, plus ein paar Stunden zum Bewerten und Aufschreiben. Für den Aufbau des Prompt-Sets dürfen Sie sich Zeit nehmen, denn jeder spätere Vergleich hängt daran, dass es stabil bleibt.
Brauche ich dafür ein kostenpflichtiges KI-Sichtbarkeits-Tool?
Nein. Die Methode oben arbeitet mit den Plattformen selbst und einer Tabelle. Bezahlte Tools werden erst für Takt und Umfang nützlich, wenn Sie eine Ausgangsmessung haben und laufend messen wollen statt einmal pro Quartal. Sie legen eine Komfortschicht über diese Methode und ersetzen sie nicht.
Warum werden Präsenz und Genauigkeit getrennt bewertet?
Weil sie unterschiedliche Arbeit verlangen. Abwesenheit deutet meist auf Zugriff, Lesbarkeit oder fehlende Bestätigung von außen. Eine falsche Beschreibung deutet auf veraltete Informationen, die noch kursieren. Ein kombinierter Wert würde eine Marke, die oft genannt, aber falsch beschrieben wird, in dieselbe Klasse setzen wie eine Marke, die niemand nennt, und beiden denselben Maßnahmenplan schicken.
Wie oft sollte das Audit wiederholt werden?
Jedes Quartal, gegen das eingefrorene Prompt-Set, jedes Mal mit Datum. Häufiger zu messen erfasst vor allem die Schwankung und nicht den Fortschritt, denn generierte Antworten unterscheiden sich schon innerhalb einer Woche. Früher dann, wenn Sie die Plattformen wechseln, ein Rebranding machen oder die Struktur Ihres Sortiments deutlich ändern.
Das Wichtigste in Kürze
Fahren Sie zwei Audits, nicht eines. Die Antwortseite sagt Ihnen, wo Sie stehen, die Seitenprüfung sagt Ihnen, warum. Die Antwortseite kommt zuerst, denn sie zeigt, welche technischen Befunde wirklich zählen.
Berichten Sie vier Kennzahlen statt eines Gesamtwerts: Präsenz, Genauigkeit, Quellenprofil und Wettbewerbsumfeld. Die eine Zahl verdeckt genau den Unterschied, der bestimmt, was als Nächstes zu tun ist.
Drei Durchläufe pro Prompt, mit Datum und mit notierter Spannweite. Eine Zahl aus einem einzigen Durchlauf eines schwankenden Systems ist keine Messung.
Vier Situationen verlangen vier unterschiedliche Antworten. Abwesenheit weist auf Zugriff und Lesbarkeit, Schwankung auf Vollständigkeit und Bestätigung, eine falsche Beschreibung auf Korrektur und eine gefestigte Position auf Verteidigen und Verbreitern.
Das Audit lohnt sich auch dann, wenn niemand sofort etwas damit macht, denn die datierte Ausgangsmessung lässt sich später nicht rekonstruieren. In einem halben Jahr lautet die Frage, ob sich die Position verbessert hat, und die ist nur zu beantworten, wenn jemand aufgeschrieben hat, wo sie begann.
Verwandte Artikel


